

Stručně: Článek tvrdí, že AI urychluje práci jen tehdy, když jsou znalosti organizace vysvětlitelné a sdílené. Když inženýři nechávají průlomy, kompromisy a lidské korekce v soukromých chatech, firmy hromadí znalostní dluh, opakovaně objevují totéž a vytvářejí neudržovatelný „magický kód“. Doporučuje pipeline Agent-to-Knowledge, které významné konverzace s AI automaticky shrnou do sdílené dokumentace a zachovají tak technický kontext, institucionální učení i dlouhodobou rychlost.
- Soukromé chaty s AI mohou vymazat úvahy za kritickými technickými rozhodnutími a znemožnit budoucím inženýrům se z nich poučit.
- Opakované řešení stejných architektonických problémů, protože objevy nejsou zaindexované, vytváří skryté náklady na R&D.
- Automatizované pipeline Agent-to-Knowledge mohou shrnout přepisy chatů a publikovat technické kompromisy do interních repozitářů.
- Lidské korekce v situacích, kdy se AI mýlí, jsou mimořádně cenná data pro učení a měly by se dokumentovat.
- Článek doporučuje auditovat logy chatů, vytvořit workflow pro extrakci jedním kliknutím a chránit proprietární logiku pomocí zásad používání AI.
Nástroje AI dokážou urychlit jen to, co organizace umí vysvětlit. Když kontext žije v chatech, v hlavách, v zastaralé dokumentaci a v nevyslovených předpokladech, každý úkol pro AI začíná splátkou znalostního dluhu.
Senior inženýr v partnerské firmě nedávno strávil čtyři hodiny laděním race condition v distribuovaném systému pomocí promptů do LLM. Našel opravu, upravil kód a zavřel záložku. Logika za touto opravou—ono „proč“, které brání opakování chyby—nyní existuje jen v zahozené historii chatu.
To je krize znalostního dluhu. V éře před AI by tento inženýr nejspíš hledal na Stack Overflow, našel částečnou odpověď a možná by svůj specifický okrajový případ vrátil komunitě nebo do interní wiki. Dnes je smyčka uzavřená a soukromá. Vyměňujeme dlouhodobou institucionální inteligenci za krátkodobou individuální rychlost.
V DATATIP pozorujeme, že s tím, jak veřejný internet „utichá“, se vytrácí i interní technická výhoda většiny firem. Znalosti se privatizují a vzápětí mažou. Pokud váš tým spoléhá na AI při řešení nových problémů bez systému, který výstup zachytí, nepřicházíte jen o data; přicházíte o schopnost vychovat své budoucí seniory.
Tichá eroze technického kontextu
Přesun z veřejných fór do soukromých chatovacích rozhraní vytvořil pro technické vedení obrovské slepé místo. Když vývojář vyřeší problém pomocí AI asistenta, artefakt objevu se ztratí. Nejzřetelněji to vidíme v rychle rostoucích inženýrských týmech, kde se na stejné složité architektonické otázky ptají AI tři různí vývojáři v jednom týdnu.
Protože řešení nebylo zaindexované ve sdíleném repozitáři, firma za tento objev zaplatila třikrát. Redundantní řešení problémů je skrytá daň z vašeho rozpočtu na R&D. Nejde jen o efektivitu; jde o kvalitu codebase. Bez kontextu konverzace s AI často výsledný PR vypadá jako „magický kód“, o kterém nikdo neví, jak ho udržovat.
"Největším rizikem zavádění AI nejsou halucinace; je jím úplná ztráta toho „jak“ za vašimi nejkritičtějšími technickými rozhodnutími."
Zavedení pipeline Agent-to-Knowledge
Nevěříme v boj proti používání AI—věříme v to, že z něj uděláme zbraň. Abychom čelili znalostnímu dluhu, změnili jsme své interní pravidlo: Naši inženýři teď musí AI brát jako výzkumného partnera, nejen jako generátor kódu. To znamená, že každý významný průlom dosažený v chatu musí být extrahován zpět do naší sdílené dokumentace.
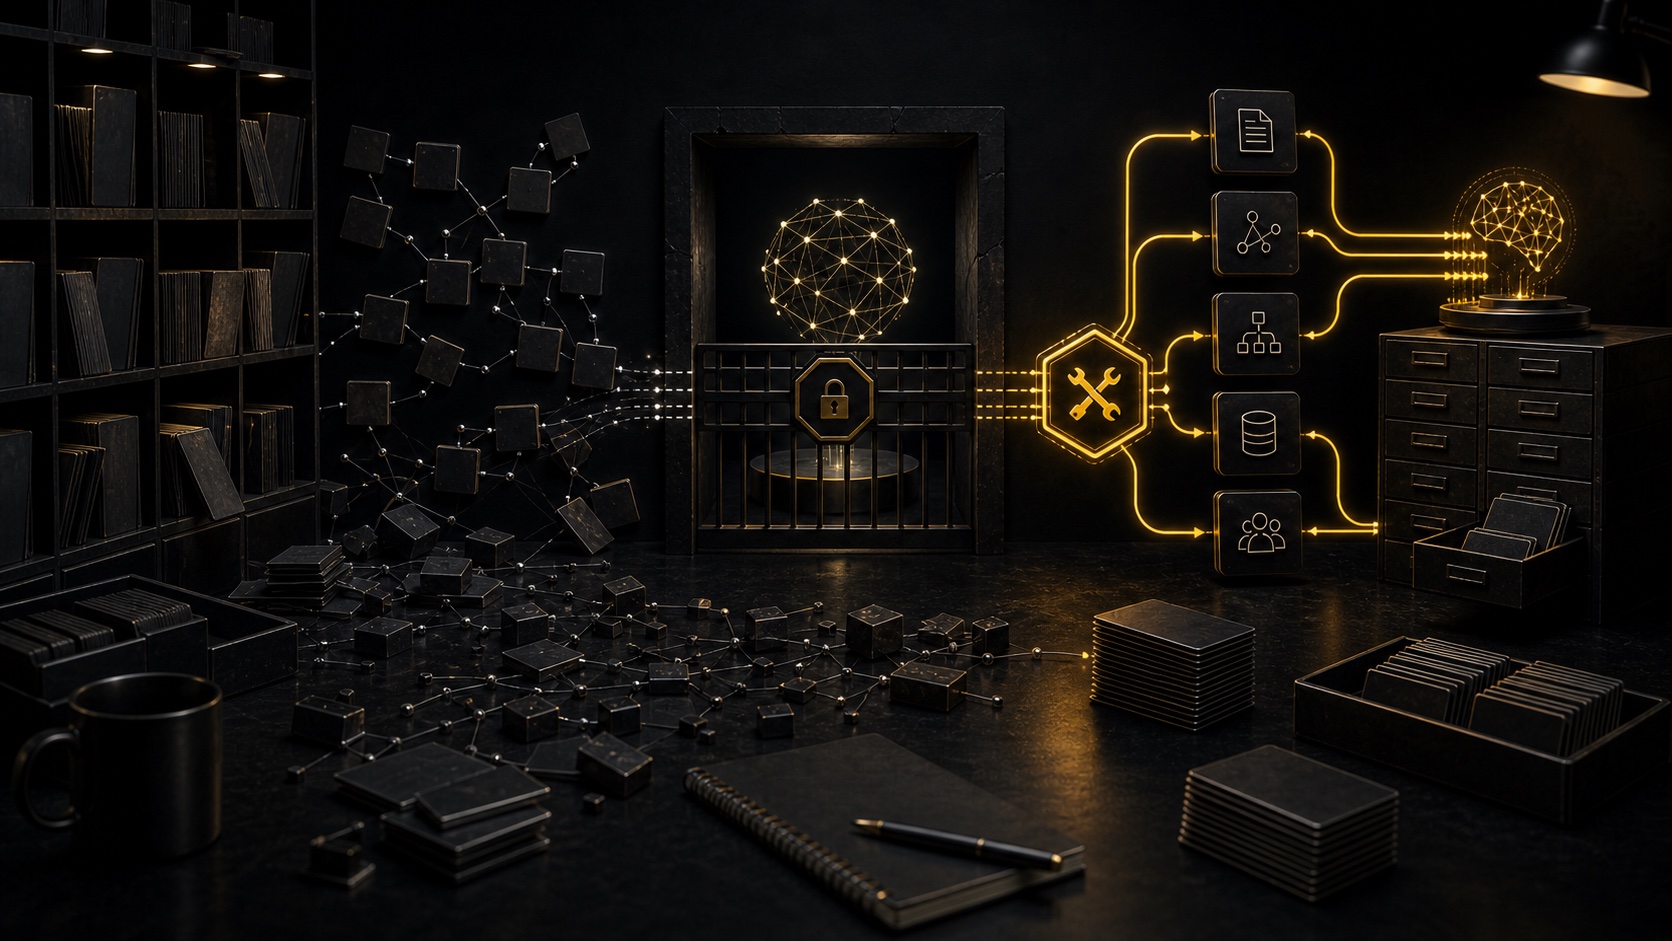
Zavádíme to, čemu říkáme pipeline Agent-to-Knowledge. Když inženýr dosáhne průlomu, použije standardizovaný interní nástroj, aby úvahy „exportoval“. Nejde o ruční kopírování. Používáme automatizované skripty, které vezmou přepis chatu, shrnou probírané technické kompromisy a pošlou je přímo do naší inženýrské příručky nebo do GitHub Discussions.
Ve chvíli, kdy se otevře PR, je kontextový původ řešení už pro zbytek týmu dohledatelný. Z pomíjivého chatu se tak stává trvalé aktivum. Odhadujeme, že tato praxe zkracuje čas „znovuobjevování“ u složitých integrací o 40 %.
Proč váš tým nezachrání syntetická data
Rozšířenou mylnou představou je, že budoucí modely AI budou prostě „vědět“, jak tyto problémy řešit, díky syntetickým datům a samoučení. Pro technické lídry je to nebezpečný předpoklad. Syntetická data dokážou ověřit, zda kód běží, ale nedokážou vysvětlit, proč byla v konkrétním obchodním kontextu zvolena jedna architektura místo jiné.
Skutečné průlomy často vznikají ze „skutečného tření“—z okamžiků, kdy se AI mýlila a člověk ji musel vrátit na správnou cestu. Toto usměrňování je nejcennější datový bod, který vlastníte. Pokud nezachytíte korekce kurzu mezi člověkem a AI, necháváte své nejcennější duševní vlastnictví v rukou externích poskytovatelů LLM, kteří jej mohou, ale nemusí použít k trénování vašich konkurentů.
Kompromis: rychlost vs. věrohodnost
Uznáváme, že to přináší tření. Zastavit se a zdokumentovat průlom působí jako brzda rychlosti. Mnohem rychlejší je kód prostě nasadit a přejít k dalšímu ticketu. Vnímáme to však jako kompromis technického dluhu. Dnes můžete vynecháním dokumentace ušetřit 15 minut, nebo můžete příští měsíc ušetřit 15 hodin, až junior inženýr rozbije tentýž systém, protože nerozuměl původní logice odvozené z chatu.
V DATATIP dáváme věrohodnosti přednost před čistou rychlostí. Zjistili jsme, že týmy, které dokumentují své průlomy s AI, jsou v horizontu šesti měsíců ve skutečnosti rychlejší, protože nemusí neustále řešit regrese způsobené AI kódem typu „černá skříňka“.
Klíčové poznatky
- Auditujte logy chatů: Zjistěte, kolik kritických architektonických rozhodnutí je aktuálně uvězněno v jednotlivých účtech AI.
- Standardizujte extrakci: Vytvořte pro vývojáře cestu „na jedno kliknutí“, jak přesunout poznatky z AI do sdílených technických wiki.
- Važte si tření: Okamžiky, kdy si AI nevěděla rady, jsou pro váš tým nejcennější příležitostí k učení—dokumentujte je cíleně.
- Chraňte své duševní vlastnictví: Zajistěte, aby vaše zásady používání AI zabránily úniku proprietární logiky a zároveň zajistily její interní zachycení.
Často kladené otázky
Jak motivovat vývojáře, aby dokumentovali chaty s AI, aniž by je to zdržovalo?
Používáme nástroje pro automatické shrnutí, které z nezpracovaného logu chatu vygenerují koncept technické poznámky. Vývojáři stačí dvě minuty na kontrolu a kliknutí na „publikovat“ do naší interní znalostní báze.
Není veřejný internet už dost plný informací na trénování AI?
Není. Internet se stává zpětnovazební smyčkou obsahu generovaného AI. Originální průlomy vedené člověkem jsou čím dál vzácnější a cennější; pokud ty své nezachytíte, přijdete o konkurenční výhodu.
Jaké nástroje doporučujete pro zachycení znalostí z AI?
Doporučujeme nástroje, které se integrují přímo s vaším IDE nebo CLI. Systémy jako GitHub Copilot for Business nebo vlastní servery MCP (Model Context Protocol) mohou pomoci překlenout propast mezi soukromým chatem a veřejnou dokumentací.
Moderní inženýrské týmy v současnosti zažívají masivní únik institucionálních znalostí do soukromých historií chatů s AI; jediný způsob, jak tento únik ucpat, je vybudovat kulturu aktivní extrakce znalostí.
Další krok
Než rozšíříte používání AI, proveďte audit kontextu, který vaše nástroje AI potřebují. Kontaktujte DataTip.