

Kurz gesagt: KI hat die Softwareentwicklung so stark beschleunigt, dass Produktteams ihre Fähigkeit überfordern können, aus Nutzern und Daten zu lernen. Der Artikel plädiert dafür, output-orientierte MVPs durch Minimum Productive Outcomes zu ersetzen: klar definierte, messbare Veränderungen im Nutzerverhalten. Führungskräfte sollten Erfolg vor dem Bauen definieren, Annahmen validieren, das Stoppen belohnen und gesparte Entwicklungszeit für menschliche Beobachtung und Kundengespräche nutzen.
- KI-generierte Features können Feedbackschleifen überfluten, sodass Teams auf Basis nicht aussagekräftiger Daten umschwenken und technische Schulden anhäufen.
- Der zentrale Engpass hat sich von der Entwicklerkapazität zu menschlichem Urteilsvermögen, Disziplin und der Fähigkeit verlagert, Nutzersignale zu verarbeiten.
- Ein Minimum Productive Outcome definiert Erfolg als messbare Verhaltensänderung und nicht bloß als funktionierende Software.
- Teams sollten „fertig“ definieren, Misserfolgsszenarien vor dem Skalieren validieren und das Löschen wirkungsloser Features belohnen.
- Die menschliche Beobachtung von Kunden bleibt unverzichtbar, da KI Zögern, Kontext oder unausgesprochene Reaktionen nicht vollständig erkennen kann.
Produktteams werden selten langsamer, weil ihnen Ideen fehlen. Sie werden langsamer, weil jede Kundenanfrage, jede Stakeholder-Meinung, jeder Alert und jeder KI-generierte Vorschlag mit demselben Gewicht ins System gelangt.
Was das in der Praxis bedeutet
- Verbindung zur Backlog-Kuratierung und zur Aufnahme KI-generierter Arbeit herstellen.
Sie haben wahrscheinlich bemerkt, dass die Hürde, Software auszuliefern, praktisch verschwunden ist. Was früher ein Quartalsbudget und ein eigenes Engineering-Team erforderte, lässt sich heute zwischen Freitagabend und Sonntagnacht mit Tools wie Claude Code, Replit und v0 prototypisch umsetzen. Diese zehnfache Verdichtung der Entwicklungszeiten fühlt sich wie eine Superkraft an, doch für viele technische Gründer und CTOs in Unternehmen mit 10 bis 200 Mitarbeitenden wird sie zu einer strukturellen Belastung. Wir erleben einen Wandel, bei dem die Kosten des Erstellens so stark gesunken sind, dass sie den Weg zum Product-Market-Fit tatsächlich zu verdecken beginnen.
Die meisten Teams gehen davon aus, dass schnellerer Output automatisch zu schnellerem Product-Market-Fit führt. Wir beobachten jedoch einen kontraintuitiven Trend: Die schiere Menge an KI-generierten Features bremst echten Fortschritt sogar aus. Wenn Sie zehn Features in der Zeit ausliefern können, die früher für eines nötig war, beschleunigen Sie nicht nur die Entwicklung – Sie fluten möglicherweise Ihre eigenen Feedbackschleifen mit Rauschen. Das ist der „unbeabsichtigte DDoS“: ein selbst verursachter Denial-of-Service-Angriff, bei dem Ihre Produktgeschwindigkeit die kognitive Kapazität Ihres Teams übersteigt, zu verstehen, was tatsächlich funktioniert.
Die Verlagerung des Engpasses: von Ressourcen zu Urteilsvermögen
Vor der KI-Ära war die Verfügbarkeit von Ressourcen der wichtigste Engpass. Sie waren dadurch begrenzt, wie viele Entwickler Sie einstellen konnten und wie viele Stunden diese mit Boilerplate-Code verbrachten. Jahrzehntelang haben wir auf „Entwicklerproduktivität“ und „Sprint-Velocity“ optimiert. Heute hat sich diese Beschränkung vollständig auf menschliches Urteilsvermögen und Disziplin verlagert. Wie Steve Blank kürzlich bei seiner Arbeit mit Startup-Kohorten beobachtete, führt der Zusammenbruch der MVP-Zeitachse dazu, dass Teams schneller ausliefern, als sie denken können. Wenn ein Studierendenteam in 48 Stunden eine funktionierende Anwendung bauen kann, wirkt das klassische zehnwöchige „Discovery“-Curriculum wie ein Relikt – und doch war der Bedarf an dieser Discovery nie dringender.
Wenn wir von einem „unbeabsichtigten DDoS“ auf die Produktgeschwindigkeit sprechen, beschreiben wir ein Szenario, in dem der Output eines Teams seine Kapazität übersteigt, Nutzersignale zu verarbeiten. Wenn Sie alle 48 Stunden eine neue Iteration ausrollen, geben Sie Ihren Nutzern – oder Ihren Daten – nie genug Zeit, Ihnen zu zeigen, ob die Änderung tatsächlich gewirkt hat. Sie führen damit faktisch einen Denial-of-Service-Angriff auf Ihren eigenen Lernprozess aus. In einem Unternehmen mit 50 Mitarbeitenden zeigt sich das als Produktteam, das auf Basis von zwei Tagen nicht aussagekräftiger Telemetrie ständig „pivotiert“ – mit der Folge einer fragmentierten Codebasis und verwirrter Nutzer.
Diese Geschwindigkeitsfalle führt oft zu dem, was wir „KI-Slop“ in der Produktstrategie nennen. Weil die Kosten für das Generieren von Code nahe null liegen, fragen Teams nicht mehr, ob ein Feature existieren sollte, sondern konzentrieren sich nur noch darauf, dass es existieren kann. Wir haben bereits argumentiert, dass Code eine Verbindlichkeit ist, und das gilt nie mehr als in einem Umfeld, in dem KI Tausende Zeilen davon in Sekunden erzeugen kann. Jede Zeile KI-generierten Codes muss gewartet, abgesichert und irgendwann refaktoriert werden. Löst dieser Code kein Kernproblem, ist er schlicht Schuldenaufbau in Hochgeschwindigkeit.
Der Kontrast: Hörsaal vs. Unternehmensrealität
Im Hörsaal ist ein KI-beschleunigtes MVP ein Lernerfolg. In einem Unternehmen mit 100 Mitarbeitenden kann es ein Desaster sein. Es steht mehr auf dem Spiel. In einer Produktivumgebung wollen Sie nicht nur sehen, ob ein Button funktioniert – Sie suchen ein skalierbares, wiederholbares Geschäftsmodell. Wenn KI die Zeit bis zum fertigen Code zusammenschrumpfen lässt, entfällt die „natürliche Reibung“, die Teams früher zwang, nachzudenken, bevor sie bauten.
Früher war der zweiwöchige Sprint eine erzwungene Besinnungspause. Sie mussten sich eines Features sicher sein, weil seine Umsetzung 20.000 € an Entwicklergehältern kosten würde. Wenn dasselbe Feature heute 0,20 € an API-Tokens und 15 Minuten Prompting kostet, verschwindet diese finanzielle und zeitliche Disziplin. Genau hier beginnt die Krise der Wissensschulden – wir bauen Systeme, die wir nicht vollständig verstehen, in einem Tempo, das wir nicht vollständig überwachen können.
Vom MVP zum Minimum Productive Outcome (MPO)
Das klassische Framework des Minimum Viable Product (MVP) hat Mühe, diese Ära der sofortigen Generierung zu überleben. Wenn sich ein MVP an einem Wochenende bauen lässt, wird das „V“ für „Viable“ zu einer gefährlich niedrigen Hürde. Wenn „tragfähig“ nur bedeutet „der Code läuft und die Oberfläche sieht ordentlich aus“, dann ist alles tragfähig. Um das zu überstehen, müssen wir das Konzept des Minimum Productive Outcome (MPO) übernehmen.
Ein MPO ist keine Software, sondern eine dokumentierte, vereinbarte Veränderung menschlichen Verhaltens. Bevor Sie einen Prompt anfassen oder eine IDE öffnen, müssen Sie genau definieren, wie Erfolg in Form von Nutzeraktionen aussieht. Das erfordert ein Maß an Disziplin, das KI nicht liefern kann. Wollen Sie Support-Tickets um 15 % reduzieren? Suchen Sie ein bestimmtes Muster wiederholter Nutzung bei Ihren slowakischen Kunden? Wenn Sie das Ergebnis nicht definieren können, ist die Geschwindigkeit, die KI Ihnen verschafft, nur ein schnellerer Weg, das Falsche zu bauen.
Betrachten Sie den Unterschied:
- MVP-Ansatz: „Lassen Sie uns mit v0 ein neues Dashboard für unsere Logistikkunden generieren und sehen, was sie davon halten.“
- MPO-Ansatz: „Wir stellen eine Datenvisualisierung bereit, mit der Disponenten verspätete Sendungen in unter 10 Sekunden erkennen, wodurch ihre durchschnittliche ‚Zeit bis zum Eingreifen‘ um 30 % sinkt.“
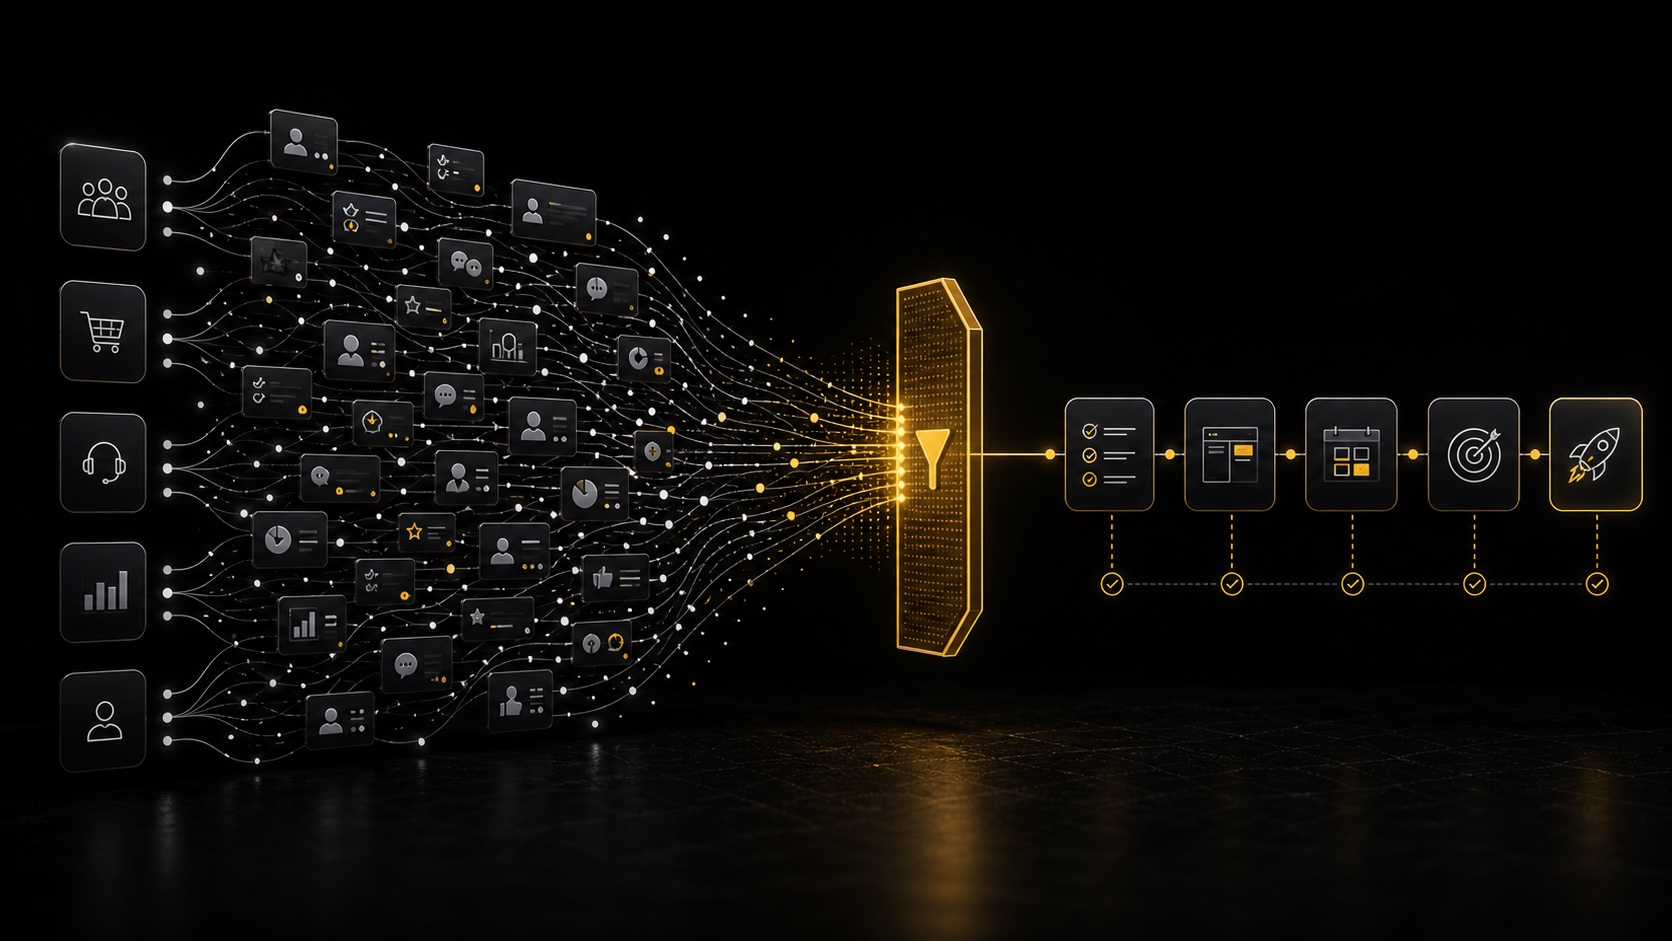
Das MPO zwingt das Team, Software als Mittel zum Zweck zu behandeln und nicht als Selbstzweck. In einem mit KI gesättigten Markt ist die Software die Massenware; das Ergebnis ist der Wert.
Der dreistufige Praxis-Stack
Um diese neue Realität zu bewältigen, müssen CTOs und Ops-Verantwortliche einen Disziplin-Stack einführen, der Denken vor Generieren stellt. Es geht nicht darum, um des Bremsens willen langsamer zu werden, sondern sicherzustellen, dass jede Auslieferung zählt. Genau hier wird Prompt Engineering zum neuen Software Engineering – weg von simpler Syntax, hin zu tiefgreifender struktureller Logik.
1. „Fertig“ definieren, bevor generiert wird
Das bedeutet, für jede KI-gestützte Iteration eine schriftliche Hypothese zu haben. Wenn Sie ein Legacy-Modul mit Claude Code refaktorieren, welche konkrete Performance- oder Wartbarkeitskennzahl streben Sie an? Ohne vorab definierten „Fertig“-Zustand iteriert die KI weiter und „halluziniert“ Verbesserungen, die Komplexität ohne Mehrwert hinzufügen. Wir haben Fälle erlebt, in denen KI-Credits beinahe eine Produktivdatenbank gekostet hätten, weil der „Fertig“-Zustand nie klar abgegrenzt war.
2. Validieren vor dem Skalieren
Nutzen Sie Tools wie Granola für die Auswertung von Meetings oder Perplexity, um Marktsignale zu validieren, bevor Sie sich auf eine vollständige Umsetzung festlegen. Wenn Ihr „unbeabsichtigter DDoS“ durch zu viel Rauschen entsteht, brauchen Sie bessere Filter. Bevor Sie ein LLM bitten, ein Feature zu bauen, bitten Sie es, drei Gründe zu finden, warum das Feature scheitern könnte. Nutzen Sie die Geschwindigkeit der KI, um den Problemraum zu erkunden, nicht nur den Lösungsraum.
3. Eine Kultur, die das Stoppen belohnt
In einem Unternehmen mit 100 Mitarbeitenden ist oft die Person am wertvollsten, die erkennt, dass ein Feature nicht funktioniert, und es beendet, bevor es technische Schulden erzeugt. Erfahrene Praktiker müssen dieses Verhalten vorleben. Wenn Sie ein Feature an einem Tag bauen können, sollten Sie bereit sein, es in einer Minute zu löschen, wenn die Daten seine Existenz nicht stützen. Belohnen Sie die Entwickler, die das „Minimum Productive Outcome“ mit möglichst wenig Code finden, nicht diejenigen, die die meisten Prompts ausliefern.
Die unverzichtbare Rolle menschlicher Analyse
Trotz der Fähigkeiten moderner LLMs bleiben menschlicher Kontakt und Beobachtung die einzigen Teile des Discovery-Prozesses, die sich nicht auslagern lassen. KI kann Ihre Komponenten schreiben, Ihre Logs zusammenfassen und sogar Nutzer-Personas simulieren. Aber sie kann nicht mit einem frustrierten Kunden in Berlin oder Bratislava in einem Raum sitzen und das leise Zögern bemerken, bevor er auf einen Button klickt. Sie kann die Stimmung eines Verkaufsgesprächs nicht spüren, in dem der Interessent „ja“ sagt, seine Körpersprache aber „das ist zu kompliziert“ signalisiert.
Wir sehen oft Gründer, die ihre gesparte Zeit nutzen, um mehr Code zu schreiben, obwohl sie damit mehr Kundengespräche führen sollten. Wenn KI Ihnen pro Woche 40 Stunden Entwicklungszeit spart und Sie diese 40 Stunden damit verbringen, Features im Umfang von 40 Stunden zusätzlich zu generieren, haben Sie nichts gewonnen. Sie haben lediglich das Volumen Ihres DDoS-Angriffs erhöht. Die wahren Gewinner dieses Wandels werden nicht diejenigen sein, die am meisten ausliefern, sondern diejenigen, die ihre verkürzten Entwicklungszyklen für mehr hochwertige menschliche Beobachtung nutzen.
Fazit: Lernen ist die einzige Geschwindigkeit, die zählt
Produktgeschwindigkeit ist eine trügerische Kennzahl. Wenn Sie mit 200 km/h in die falsche Richtung fahren, sind Sie nicht „schnell“ – Sie haben sich nur verirrt. Der „unbeabsichtigte DDoS“ entsteht, wenn wir die Geschwindigkeit unserer Tools mit der Geschwindigkeit unseres Geschäfts verwechseln.
Je weiter wir in diese Ära der automatisierten Entwicklung vordringen, desto mehr verändert sich unsere Rolle als technische Führungskräfte. Wir sind nicht mehr die Vorarbeiter einer Code-Fabrik, sondern die Kuratoren eines Lernprozesses. Wir müssen unsere Teams vor dem Rauschen ihrer eigenen Produktivität schützen. Letztlich ist Ihre Produktgeschwindigkeit dadurch begrenzt, wie schnell Sie lernen können, nicht wie schnell Sie tippen können. Konzentrieren Sie sich auf das Minimum Productive Outcome, pflegen Sie Ihren Disziplin-Stack und denken Sie daran, dass jenseits des Tools das Ziel immer eine Veränderung menschlichen Verhaltens ist, nicht bloß eine höhere Zahl an Commits.
Nächster Schritt
Überprüfen Sie Ihren Produkt-Intake, bevor Sie weitere Automatisierung hinzufügen. Sprechen Sie mit DataTip.