

W skrócie: Artykuł dowodzi, że ambitne produkty łączone w pakiety, czyli „super aplikacje”, często zawodzą, ponieważ ich schematy danych projektowano z myślą o usługach jednozadaniowych. Przed połączeniem usług zespoły powinny przeanalizować rozpoznawanie tożsamości, przestrzenie nazw zdarzeń i wymagania dotyczące współbieżności; utrzymywać modularne usługi danych, unikać przerośniętych „God Tables” i stosować dynamiczne interfejsy ukrywające złożoność. Jeśli integracja daje użytkownikom niewielką wartość lub generuje nadmierne koszty utrzymania, lepszym wyborem mogą być osobne produkty.
- Warto sprawdzić, czy użytkownicy mogą mieć różne role, cykle rozliczeniowe, uprawnienia i wymagania dotyczące lokalizacji danych w różnych usługach.
- Ścisłe przestrzenie nazw zdarzeń i modularne usługi danych zapobiegają kolizjom w analityce i kompromisom w bazie danych.
- Nie należy wtłaczać odmiennych obciążeń, takich jak czat i płatności, do jednego schematu ani jednej bazy danych.
- Przed decyzją o połączeniu usług warto zmierzyć podatek integracyjny w czasie deweloperów i zdolności utrzymaniowej.
- Dynamiczne interfejsy pozwalają ukryć złożoność backendu; łączenia usług warto unikać, gdy dane współdzielone między usługami dają użytkownikom ograniczoną wartość.
Ambicje produktowe często wyprzedzają model danych. Dług ujawnia się później, gdy każda nowa funkcja wymaga wyjątków, zadań synchronizacji, zduplikowanego stanu lub ręcznego porządkowania.
50-osobowy zespół SaaS spędzał niedawno 12 godzin tygodniowo na ręcznym raportowaniu, ponieważ próbował połączyć starsze narzędzie do czatu z nową ofertą fintech. Zespół sądził, że „pakiet” zwiększy retencję; zamiast tego w ciągu sześciu miesięcy wywołał spiralę długu technicznego. Większość założycieli postrzega „super aplikację” jako wyzwanie UI, ale prawdziwym cmentarzyskiem jest architektura danych.
X Elona Muska, Disney i Uber mogą sobie pozwolić na przebrnięcie przez ogromne fuzje usług metodą „vibe codingu”, ponieważ mają tysiące inżynierów, którzy siłowo przepchną integrację. Dla 100-osobowego startupu wciśnięcie „X Money” w starszy schemat „X Chat” to nie ewolucja – to misja samobójcza dla warstwy raportowej. Jeśli kluczowe tabele nie zostały zbudowane z myślą o logice wielopodmiotowej, ambicje produktowe utkną, zanim pierwsza aktualizacja trafi do App Store.
Wysoki koszt dochodzenia do pakietu metodą „vibe codingu”
Gdy liderzy decydują się połączyć usługi – jak Airbnb dodające wynajem samochodów czy OpenAI łączące ChatGPT z narzędziami przeglądarkowymi – często pomijają realia infrastruktury. W jednym z niedawnych projektów widzieliśmy, jak średniej wielkości firma próbowała zintegrować drugą linię produktów z główną aplikacją. Ponieważ pierwotny schemat używał na sztywno zakodowanego user_id jako klucza głównego dla całej logiki transakcji, nie mogła obsłużyć użytkowników pełniących różne role w różnych usługach.
To nie jest tylko kwestia konwencji nazewnictwa. To fundamentalna niezgodność między logiką biznesową a grawitacją danych. Gdy wtłacza się odmienne usługi do jednego worka, złożoność zapytań nie tylko się podwaja; rośnie wykładniczo. Kończy się to „God Tables” o szerokości ponad 100 kolumn, których nie da się efektywnie zindeksować. Zanim w poniedziałek rano zapadnie decyzja o połączeniu usług, trzeba sobie uświadomić, że kod jest zobowiązaniem, a każda nowa funkcja nakłada trwały podatek na wydajność systemu.
Dlaczego zachodnie „aplikacje do wszystkiego” zwykle upadają na poziomie bazy danych
WeChat i KakaoTalk odniosły sukces, ponieważ od pierwszego dnia budowano je jako ekosystemy. Na Zachodzie budujemy wysoce wyspecjalizowane, „jednozadaniowe” aplikacje, takie jak Uber czy Twitter. Gdy takie aplikacje próbują zwrócić się w stronę modelu „super aplikacji”, walczą z latami kostnienia schematu.
„Tabela z 10 milionami wierszy zoptymalizowana pod prosty messaging załamie się w chwili, gdy spróbuje się ją złączyć z księgą transakcji finansowych o wysokiej częstotliwości.”
Meta jest sztandarowym przykładem tych zmagań. Przez dekadę łączyła i rozdzielała Messengera i Zdjęcia, ponieważ przerost doświadczenia użytkownika jest często bezpośrednim odbiciem bałaganu w danych. Jeśli deweloperzy spędzają więcej czasu na pisaniu instrukcji „if-else” obsługujących przypadki brzegowe między połączonymi usługami niż na wdrażaniu nowych funkcji, nie powstaje super aplikacja – powstaje monolit zbyt ciężki, by go poruszyć.
Techniczne due diligence: co sprawdzić przed połączeniem usług
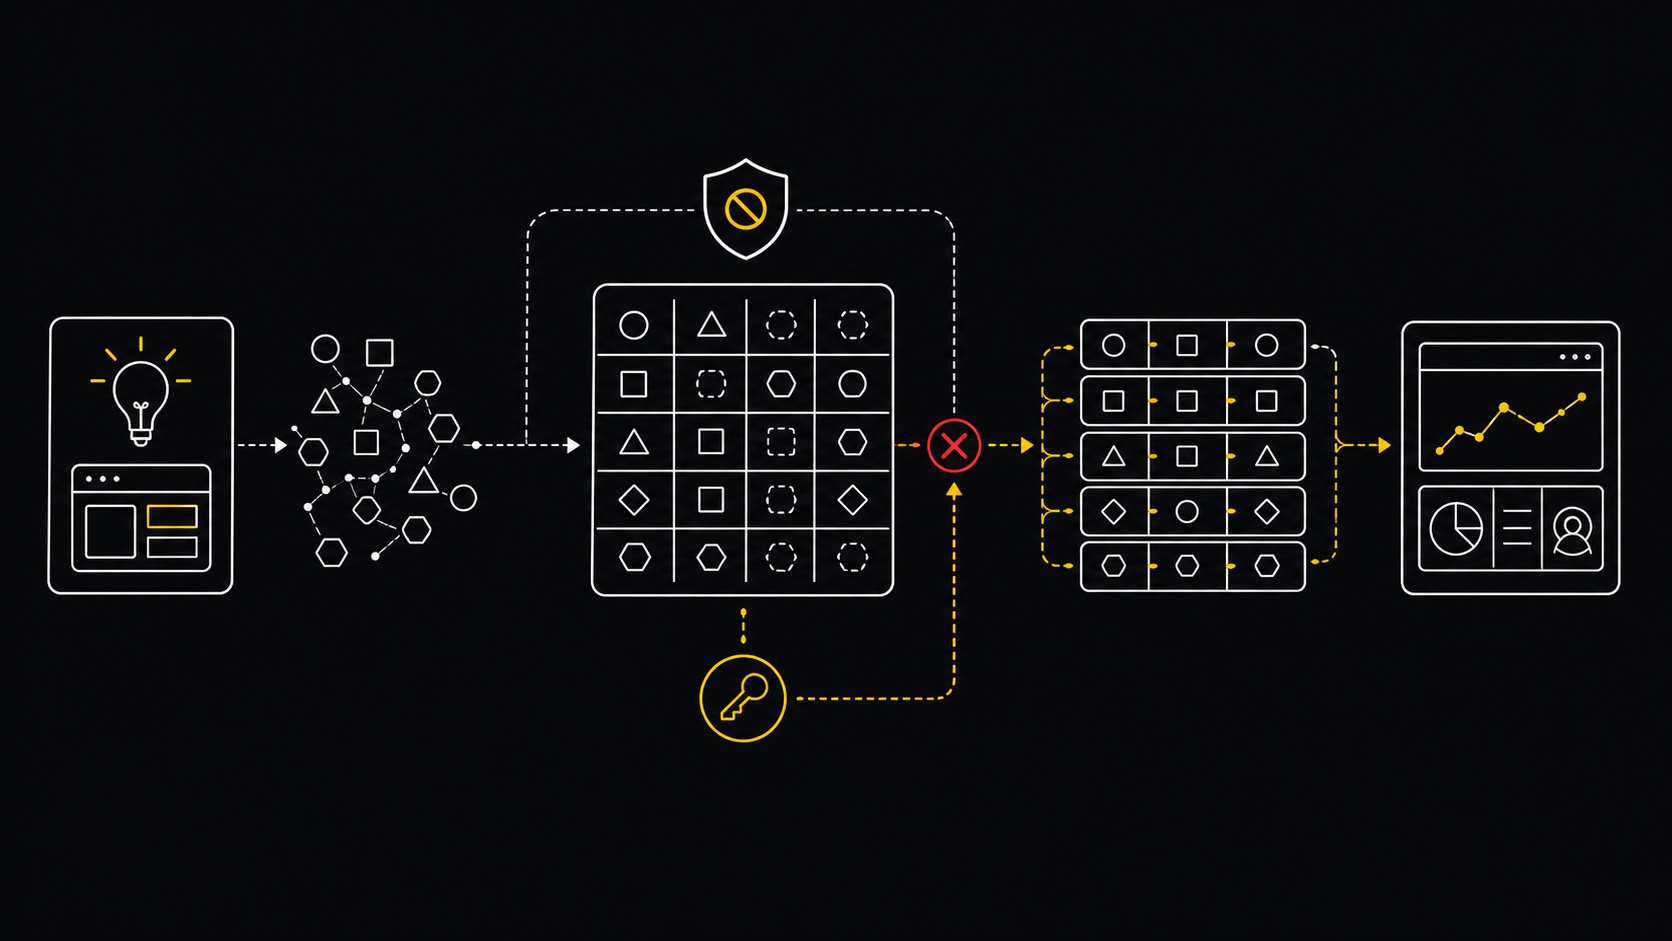
Zanim zapadnie decyzja o interfejsie obejmującym wiele usług, trzeba chłodnym okiem przeprowadzić audyt systemów danych. W przeciwnym razie okaże się, że 40% ról technicznych trafia do utrzymania zamiast do innowacji. Warto zacząć od tych trzech kontroli:
- Rozpoznawanie tożsamości: Czy system obsłuży jednego użytkownika z różnymi zestawami uprawnień, cyklami rozliczeniowymi i wymaganiami dotyczącymi lokalizacji danych w obrębie „pakietu”? Jeśli tabela
usersjest jedynym źródłem prawdy, prawdopodobnie jest zbyt sztywna. - Kolizje zdarzeń: Gdy użytkownik „klika” w aplikacji, czy schemat analityczny wie, czy to kliknięcie należy do usługi „Chat”, czy „Payments”? Bez ścisłej strategii przestrzeni nazw business intelligence zamieni się w gabinet luster.
- Limity współbieżności: Jeśli usługa „Money” wymaga zgodności z ACID, a usługa „Chat” jest zoptymalizowana pod spójność ostateczną, umieszczenie ich w tej samej bazie danych zmusi do wyboru między szybkością a integralnością danych.
Pułapka „Microsoft Office”: przerost UX jako objaw problemu z danymi
Gdy usługa zaczyna wymagać zagnieżdżonych menu i złożonych list rozwijanych, w praktyce powstaje mobilna wersja Microsoft Office. Dzieje się tak, ponieważ zespół produktowy próbuje wyeksponować każdą nową encję danych dodaną w backendzie. OpenAI musiało niedawno uprościć interfejs ChatGPT, ponieważ podejście „wszystko w jednym” sprawiało, że narzędzie stawało się nieużyteczne dla przeciętnego konsumenta.
Aby tego uniknąć, warto przyjrzeć się, jak Netflix radzi sobie ze złożonością. Nie pokazuje wszystkiego naraz; używa dynamicznie serwowanych interfejsów napędzanych przez AI, które ukrywają złożoność. Wymaga to silnie rozprzęgniętej warstwy danych, w której UI nie musi znać struktury każdej tabeli, by wyrenderować przejrzysty ekran główny. Jeśli nie opanowano autopilotów AI i transformacji cyfrowej na poziomie architektury, super aplikacja będzie przypominać szufladę z rupieciami.
Kiedy NIE łączyć usług: argumenty za pozostaniem małym
Łączenie usług to strategia wzrostu, ale często służy odwróceniu uwagi od głównego produktu, który stoi w miejscu. Jeśli ekonomika jednostkowa usługi A się nie spina, dodanie usługi B do tej samej aplikacji jej magicznie nie naprawi – jedynie ukryje stratę w bardziej złożonym rachunku zysków i strat (P&L).
Dla startupu zatrudniającego 100 osób koszt utrzymania infrastruktury super aplikacji może pochłonąć 30–50% całkowitych zasobów inżynierskich. O ile przenikanie się danych między obiema usługami nie zapewnia użytkownikowi 10x lepszego doświadczenia, lepiej utrzymać je jako osobne, odchudzone byty. Pragmatyczna inżynieria danych oznacza wiedzę, kiedy powiedzieć „nie” „zunifikowanemu” widokowi, który nie daje żadnej realnej wartości biznesowej.
Najważniejsze wnioski
- Przeanalizuj warstwę tożsamości przed połączeniem usług; jeśli system nie obsługuje logiki wielodzierżawnej w obrębie jednego użytkownika, pakiet się nie uda.
- Unikaj „God Tables”, stosując podejście mikroserwisowe do danych, nawet jeśli UI wygląda jak jedna aplikacja.
- Mierz „podatek integracyjny” w godzinach pracy deweloperów; jeśli synchronizacja usług zajmuje ponad 20% sprintu, wąskim gardłem jest schemat.
- Stawiaj na dynamiczne UI, które ukrywają złożoność, zamiast eksponować każdą nową funkcję na ekranie głównym.
Najczęściej zadawane pytania
Skąd wiadomo, czy obecny schemat jest gotowy na przejście do super aplikacji?
Jeśli główne tabele bazy danych wymagają więcej niż trzech złączeń, by odpowiedzieć na podstawowe pytanie o zachowanie użytkowników w różnych zestawach funkcji, schemat jest prawdopodobnie zbyt sztywny. Warto też sprawdzić, czy kluczowe tabele użytkowników i transakcji nie zawierają na sztywno zakodowanych zależności od logiki specyficznej dla poszczególnych usług.
Jaki jest największy ukryty koszt łączenia osobnych aplikacji?
Największym kosztem jest „dług kontekstowy” (Context Debt), gdy deweloperzy muszą rozumieć cały powiązany system, aby zmienić jedną funkcję. Często prowadzi to do 30% spadku częstotliwości wdrożeń, ponieważ powierzchnia testów rozszerza się na wszystkie połączone usługi.
Czy w super aplikacji używać jednej bazy danych dla wszystkich usług?
Prawie nigdy. Choć UI jest zunifikowane, warstwa danych powinna pozostać modularna. Użycie jednej bazy danych dla odmiennych usług, takich jak „Chat” i „Payments”, tworzy pojedynczy punkt awarii i wymusza kompromisy w strojeniu wydajności bazy pod różne obciążenia.
Super aplikacja to nie wybór projektowy; to zobowiązanie architektoniczne, które albo przeskaluje Państwa biznes, albo pogrzebie zespół inżynierski pod niepotrzebnym długiem.
Następny krok
Sprawdź, czy Twój schemat danych udźwignie roadmapę produktu. Porozmawiaj z DataTip.