

Stručně: Článek tvrdí, že technický obsah ztrácí hodnotu, když extrakce odstraní omezení, jednotky, výhrady a záměr zdroje. Doporučuje přísný postup podobný práci s kódem: zachovat pořadí argumentů a tvrdá fakta, sjednotit jednotky a data, odstranit marketingový jazyk, ukázat kompromisy, zdokumentovat rozpory a validovat strukturovaný výstup. Přístup se hodí pro technickou dokumentaci a provozní příručky, ne však pro kreativní nebo čistě inspirativní marketingový obsah.
- Chraňte věrnost zdroji: nevymýšlejte tvrzení, nedoplňujte chybějící data a nenechte SEO ani hlas značky převážit nad fakty.
- Omezení, výhrady, jednotky, pojmenované entity a jedinečné příklady berte jako informace, které se musí zachovat.
- Používejte metrické jednotky, data ve formátu DD.MM.RRRR, konzistentní schémata, validní JSON, správu verzí a automatizovaný linting.
- Když si zdroje odporují, zdokumentujte obě tvrzení, místo abyste rozpory řešili domněnkami.
- Rámec používejte pro technický a provozní obsah, ne pro kreativní marketing, storytelling značky nebo vágní teoretický materiál.
Technický obsah se prodraží, když extrakce ztratí omezení, jednotky, hraniční případy a záměr zdroje. Zacházet s obsahem jako s kódem tu není metafora; je to způsob, jak udržet navazující systémy spolehlivé.
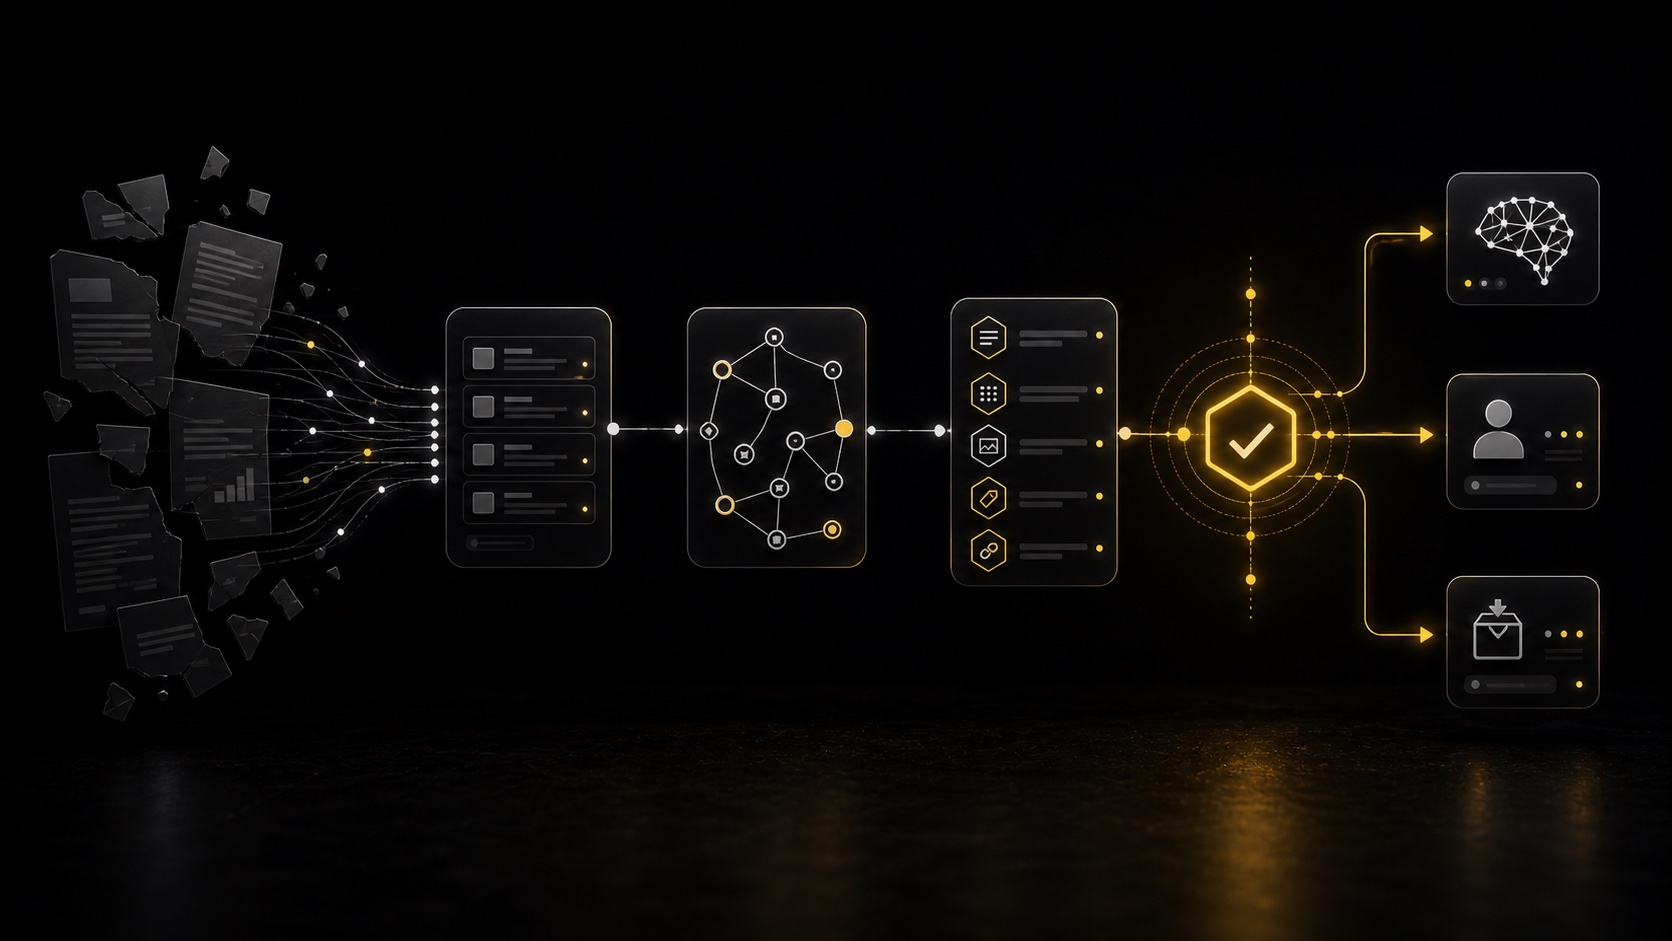
Postup extrakce ve 12 krocích
- Čtěte kvůli hlavní tezi: Určete hlavní technický argument, aniž byste přidávali vnější interpretace.
- Zmapujte pořadí argumentů: Zachovejte logický tok původního autora, aby zůstala zachována integrita důkazu.
- Izolujte tvrdá fakta: Vytáhněte čísla, konkrétní produkty a pojmenované entity. Pokud zdroj uvádí 50 ms, výstup uvádí 50 ms.
- Identifikujte omezení: Zaznamenejte, co systém nedokáže. V technické dokumentaci jsou výhrady důležitější než funkce.
- Zkontrolujte jednotky: Jakékoli nemetrické jednotky okamžitě převeďte na m, kg nebo °C. Pokud zdroj zmiňuje 10 mil, převedete je na 16 km.
- Odfiltrujte šum značky: Odstraňte marketingovou vatu samotného zdroje. Pokud zdroj něco nazývá 'revolučním', zredukujeme to na funkční popis.
- Uplatněte lokalizaci: Zajistěte, aby data odpovídala formátu DD.MM.RRRR a aby práce s měnou nepoužívala symboly specifické pro USA.
- Sladění s personou: Zbývající fakta přepište hlasem 'seniorního praktika' – přímo a jako kolega kolegovi.
- Vložte kompromisy: Zajistěte, aby byl na základě omezení zdroje jasně definován případ 'kdy nepoužívat'.
- Zkontrolujte interní odkazy: Přidejte kontextově relevantní odkazy na související inženýrské koncepty, jako jsou suverénní stacky.
- Ověřte integritu JSON: Zajistěte splnění všech požadavků na metadata a schéma, aby byl výstup parsovatelný.
- Závěrečná kontrola věrnosti: Porovnejte koncept se zdrojem a ujistěte se, že nebyla vymyšlena žádná nová tvrzení, čísla ROI ani velikosti týmů.
Při analýze zdroje musíte identifikovat jedinečná tvrzení a příklady, které definují jeho hodnotu. Pokud například technická studie zdůrazňuje konkrétní latenci 50 ms, je toto číslo faktem, který 'se musí zachovat'. Nedovolíme, aby hlas značky tyto tvrdé technické hrany zjemnil. Jak jsme probírali v článku o zvládání úzkého hrdla produktivity AI, cílem je odstranit tření mezi zdrojovými daty a finální implementací.
Věrnost a požadavky na výstup
Věrnost v tomto rámci znamená, že faktická páteř zdroje je chráněna před 'kreativními' choutkami autora nebo modelu. K jejímu vynucení používáme smlouvu o věrnosti zdroji. Ta stanoví, že pokud pokyny značky požadují obchodní výsledek, který ve zdroji není, požadavek vypustíme. Nevymýšlíme. Nevatujeme.
JSON jako konečná pravda
V tomto rámci je výstup v JSON 'zdrojem pravdy' pro publikační systém. Vynucuje schéma, které zahrnuje meta titulky, klíčová slova a položky FAQ. Tím, že tato pole musí být vyplněna přímo ze zdrojového materiálu, zajišťujeme, že SEO je vedlejším produktem dobré technické dokumentace, ne samostatnou marketingovou vrstvou, která fakta zkresluje. Pokud zdrojový materiál konkrétní položku FAQ nepodporuje, nezahrneme ji. Raději máme kratší a přesnější dokument než dlouhý a spekulativní.
To je obzvlášť důležité při generování strukturovaných dat, jako je JSON. Výstup musí být parsovatelný a validní a musí dodržovat přísnou hierarchii zdroje. Viděli jsme, jak mezera v předvídatelnosti způsobuje problémy v moderních implementacích AI; totéž platí pro extrakci dat. Pokud extrakční rámec připouští 'volný' JSON nebo nekonzistentní mapování schématu, navazující systémy – ať už LLM, nebo tradiční databáze – nakonec selžou. Jde o běžnou formu znalostního dluhu, který se v čase kumuluje.
Detaily implementace pro technické týmy
Při zavádění tohoto rámce doporučujeme zacházet s repozitářem obsahu jako s codebase. To znamená používat správu verzí (Git) pro zdrojové soubory JSON a spouštět automatizované lintery, které kontrolují zakázané výrazy nebo nesprávné formáty dat.
Práce se složitým zdrojovým materiálem
Pokud zdrojový materiál obsahuje protichůdná fakta, rámec vyžaduje, abyste rozpor zdokumentovali, místo abyste ho vyřešili domněnkou. V tom je rozdíl mezi juniorním redaktorem a seniorním praktikem. Juniorní redaktor může zvolit 'nejpravděpodobnější' číslo, aby text lépe plynul. Seniorní praktik uvede, že 'Zdroj A uvádí latenci 100 ms, zatímco zdroj B uvádí 150 ms,' a zachová tak pro čtenáře technickou realitu.
Tato úroveň detailu je zásadní u suverénních stacků, kde technické nuance rozhodují o úspěchu celé infrastruktury. Viděli jsme případy, kdy ignorování drobného omezení ve fázi extrakce vedlo ke scénáři otráveného repozitáře, protože bezpečnostní varování byla odstraněna ve prospěch 'čistšího' textu.
Praktický příklad extrakce
Představte si zdrojový dokument popisující novou API gateway. Zdroj uvádí, že zvládne 10 000 požadavků za sekundu, ale při zpracování payloadů nad 5 MB má únik paměti. Extrakce vedená marketingem by se mohla soustředit jen na propustnost 10 tisíc. Náš rámec vyžaduje, aby omezení 5 MB bylo výrazně vidět. Omezení považujeme za entitu s vysokou prioritou. Díky tomu má vedoucí provozu, který čte shrnutí, stejné kritické informace jako inženýr, který přečetl 50stránkový whitepaper.
Kdy tento rámec pro analýzu a extrakci technického obsahu nepoužívat
O kompromisech mluvíme otevřeně: tento rámec není univerzální řešení. Nepoužívejte ho pro kreativní marketingové texty, storytelling značky ani vizionářské texty, jejichž cílem je inspirovat, nikoli informovat. Rámec je určen pro technickou dokumentaci, terénní poznámky k infrastruktuře a provozní příručky.
Pokud se snažíte napsat 'virální' příspěvek na sociální sítě, který stojí na emocionálních spouštěčích, a ne na faktech podložených daty, tato míra přísnosti vám bude jen překážet. Je to nástroj pro přesnost, ne pro přesvědčování. Pokud navíc pracujete se zdrojem, který je záměrně vágní nebo čistě teoretický bez konkrétních datových bodů, vtěsnání do tohoto rámce pravděpodobně povede k velmi tenkému a neužitečnému výstupu. Aby byl rámec účinný, potřebuje zdrojový materiál s 'masem' na kostech.
Hlavní poznatky
- Věrnost zdroji je hlavní metrikou: Nikdy nenechte hlas značky nebo cíle SEO převážit nad faktickou páteří zdrojového materiálu.
- Standardizujte na evropské jednotky: Používejte výhradně metrické jednotky (kg, m, °C) a formát DD.MM.RRRR, abyste předešli přeshraničním technickým chybám.
- Uplatněte personu seniorního praktika: Mluvte jako kolega, vyhýbejte se marketingovým klišé a buďte upřímní ohledně omezení nástrojů, které doporučujete.
- Vynucujte přísné formátování výstupu: Ať jde o JSON, nebo Markdown, struktura musí být parsovatelná a konzistentní, aby nevznikal technický dluh.
- Včas identifikujte fakta, která 'se musí zachovat': Než začnete s přepisem, izolujte tvrdé datové body, jedinečné příklady a technická omezení.
Často kladené otázky
Proč zakazujete americké jednotky jako palce a míle?
V technickém kontextu znamená konzistence bezpečnost. Pro evropské firmy zajišťují metrické jednotky, že všichni od vývoje po provoz mluví stejným jazykem bez nutnosti ručního převodu, který je častým zdrojem chyb. Předchází se tak selhání typu 'Mars Climate Orbiter', kdy nesoulad jednotek vede ke katastrofálním následkům.
Mohu tento rámec použít pro marketingové blogy?
Ne. Tento rámec je vytvořen speciálně pro technický obsah, u kterého jsou faktická přesnost a strukturální integrita důležitější než 'plynulost' nebo emocionální zapojení. Pro marketing je potřeba flexibilnější přístup, který umožňuje narativní oblouky a aspirační jazyk.
Co když ve zdrojovém materiálu chybějí data?
Pokud ve zdrojovém materiálu chybějí kritická fakta, rámec vyžaduje, abyste mezeru označili, místo abyste ji zaplnili domněnkami. Z pohledu seniorního praktika je lepší říct 'zdroj latenci neuvádí', než číslo odhadovat. Tím se zachová integrita extrakce.
Jak rámec zachází s obsahem generovaným AI?
Tento rámec funguje pro AI jako 'svodidla'. Díky přísné smlouvě o věrnosti zdroji a 12krokovému postupu snižujeme pravděpodobnost halucinací AI. Nutí model držet se v hranicích poskytnutých faktů, podobně jako linter nutí kód dodržovat pravidla syntaxe.
Uzavření mezery mezi surovými informacemi a použitelným technickým obsahem vyžaduje změnu v tom, jak přemýšlíme o 'psaní'. Když obsah chápeme jako problém extrakce dat, a ne jako kreativní úlohu, stavíme systémy, které jsou spolehlivější a snáze se udržují. Až budete dolaďovat vlastní rámec pro analýzu a extrakci technického obsahu, pamatujte, že cílem není, aby obsah zněl lépe – ale aby lépe fungoval ve vašem technickém stacku.
Další krok
Než začnete technický obsah migrovat nebo automatizovat, použijte tento rámec. Poraďte se s DataTip.