

Kurz gesagt: Der Artikel argumentiert, dass technische Inhalte an Wert verlieren, wenn bei der Extraktion Einschränkungen, Einheiten, Vorbehalte und die Absicht der Quelle verloren gehen. Er empfiehlt einen strikten, codeähnlichen Workflow: Argumentationsreihenfolge und harte Fakten bewahren, Einheiten und Datumsangaben vereinheitlichen, Marketingsprache entfernen, Zielkonflikte offenlegen, Widersprüche dokumentieren und strukturierte Ausgaben validieren. Der Ansatz eignet sich für technische Dokumentation und operative Leitfäden, nicht aber für kreative oder rein inspirierende Marketinginhalte.
- Schützen Sie die Quelltreue: Erfinden Sie keine Aussagen, füllen Sie keine Datenlücken und lassen Sie SEO und Markenstimme nicht über Fakten dominieren.
- Behandeln Sie Einschränkungen, Vorbehalte, Einheiten, benannte Entitäten und einzigartige Beispiele vorrangig als unverzichtbare Informationen.
- Verwenden Sie metrische Einheiten, Datumsangaben im Format TT.MM.JJJJ, konsistente Schemas, valides JSON, Versionskontrolle und automatisiertes Linting.
- Widersprechen sich Quellen, dokumentieren Sie beide Aussagen, statt Abweichungen durch Annahmen aufzulösen.
- Nutzen Sie das Framework für technische und operative Inhalte, nicht für kreatives Marketing, Brand Storytelling oder vages theoretisches Material.
Technische Inhalte werden teuer, wenn bei der Extraktion Einschränkungen, Einheiten, Grenzfälle und die Absicht der Quelle verloren gehen. Inhalte wie Code zu behandeln, ist hier keine Metapher – so halten Sie nachgelagerte Systeme zuverlässig.
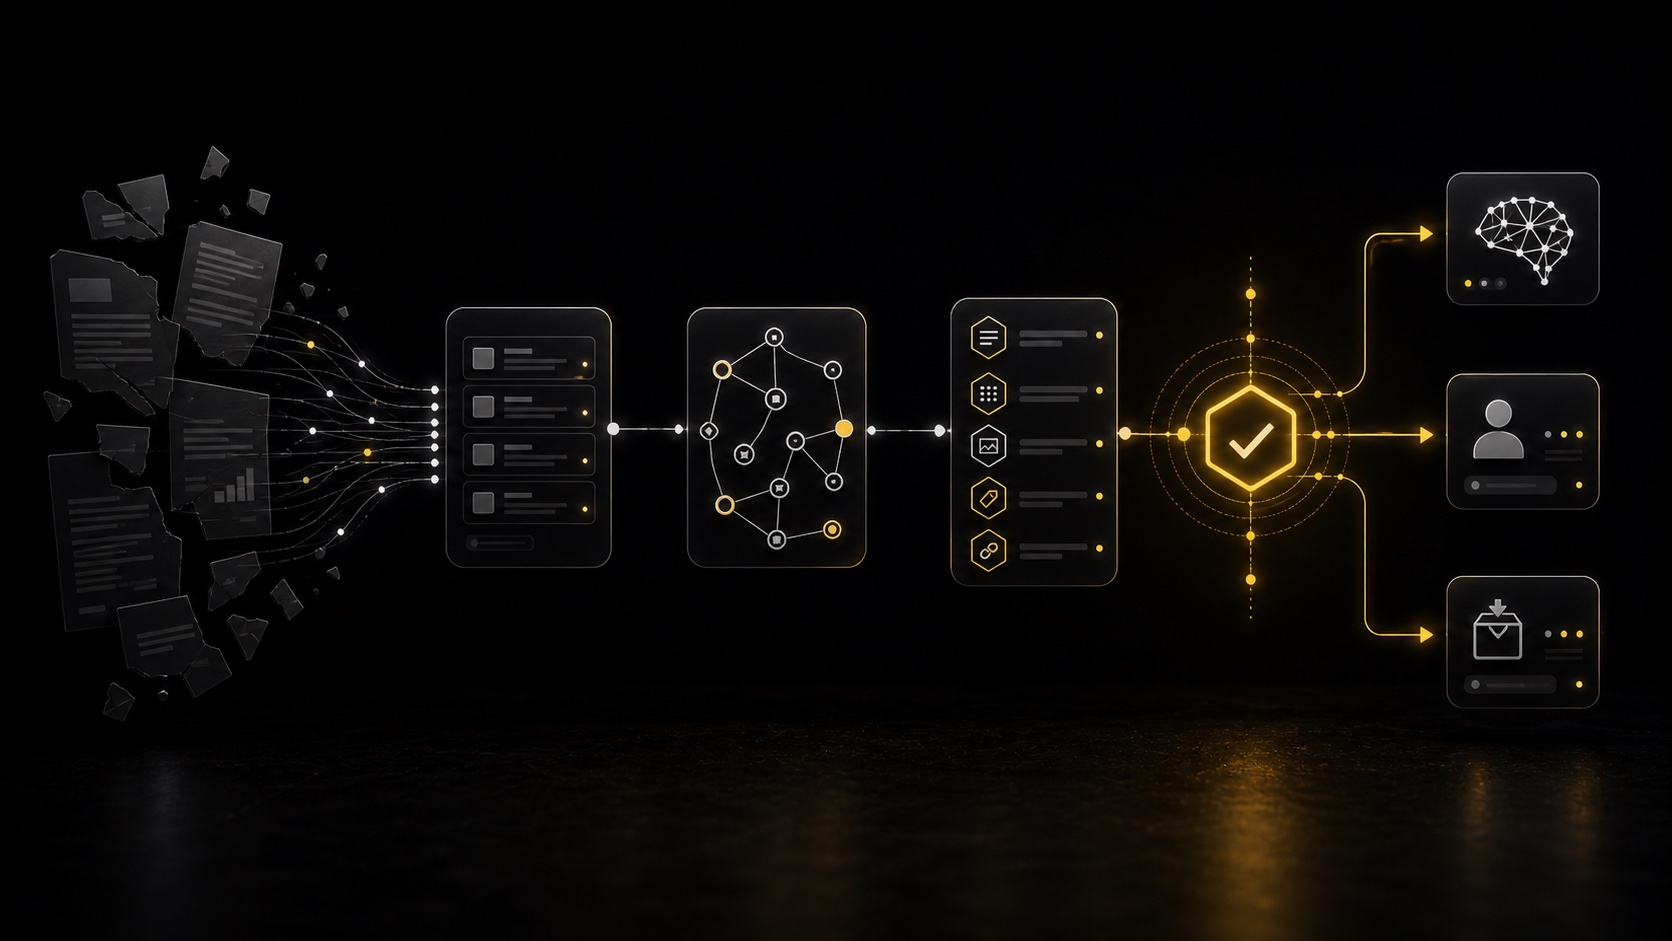
Der Extraktions-Workflow in 12 Schritten
- Die Kernthese erfassen: Identifizieren Sie das zentrale technische Argument, ohne externe Interpretationen hinzuzufügen.
- Die Argumentationsreihenfolge abbilden: Bewahren Sie den logischen Aufbau des ursprünglichen Autors, damit die Beweisführung intakt bleibt.
- Harte Fakten isolieren: Extrahieren Sie Zahlen, konkrete Produkte und benannte Entitäten. Steht in der Quelle 50 ms, steht in der Ausgabe 50 ms.
- Einschränkungen identifizieren: Halten Sie fest, was das System nicht kann. In technischer Dokumentation sind Vorbehalte wichtiger als Funktionen.
- Einheiten prüfen: Rechnen Sie nicht-metrische Einheiten sofort in m, kg oder °C um. Nennt die Quelle 10 Meilen, rechnen Sie in 16 km um.
- Markenrauschen herausfiltern: Entfernen Sie die Marketing-Füllwörter der Quelle. Bezeichnet die Quelle etwas als „revolutionär“, reduzieren wir es auf die funktionale Beschreibung.
- Lokalisierung anwenden: Stellen Sie sicher, dass Datumsangaben dem Format TT.MM.JJJJ folgen und Währungsangaben keine US-spezifischen Symbole verwenden.
- An die Persona anpassen: Formulieren Sie die verbleibenden Fakten in der Stimme eines „erfahrenen Praktikers“ um – direkt und auf Augenhöhe.
- Zielkonflikte einfügen: Stellen Sie sicher, dass der Fall „wann nicht verwenden“ auf Basis der Einschränkungen der Quelle klar definiert ist.
- Interne Links prüfen: Fügen Sie kontextuell relevante Links zu verwandten Engineering-Konzepten wie souveränen Stacks hinzu.
- JSON-Integrität prüfen: Stellen Sie sicher, dass alle Metadaten- und Schema-Anforderungen für eine parsbare Ausgabe erfüllt sind.
- Abschließende Treueprüfung: Vergleichen Sie den Entwurf mit der Quelle, um sicherzustellen, dass keine neuen Aussagen, ROI-Zahlen oder Teamgrößen erfunden wurden. Wenn Sie eine Quelle analysieren, müssen Sie die einzigartigen Aussagen und Beispiele identifizieren, die ihren Wert ausmachen. Hebt ein technisches Paper beispielsweise eine bestimmte Latenz von 50 ms hervor, ist diese Zahl ein Fakt, der „unbedingt erhalten bleiben muss“. Wir lassen nicht zu, dass die Markenstimme diese harten technischen Kanten abschwächt. Wie wir in unserem Beitrag über den Umgang mit dem KI-Produktivitätsengpass erläutert haben, besteht das Ziel darin, die Reibung zwischen den Quelldaten und der finalen Umsetzung zu beseitigen.
Quelltreue und Anforderungen an die Ausgabe
Quelltreue bedeutet in diesem Framework, dass das faktische Rückgrat der Quelle vor den „kreativen“ Anwandlungen des Autors oder des Modells geschützt wird. Um das durchzusetzen, nutzen wir einen Source Fidelity Contract. Dieser Vertrag legt fest: Verlangt die Markenrichtlinie ein Geschäftsergebnis, das nicht in der Quelle steht, verwerfen wir die Anforderung. Wir erfinden nichts. Wir füllen nichts auf.
JSON als letzte Wahrheit
In diesem Framework ist die JSON-Ausgabe die „Source of Truth“ für das Publikationssystem. Sie erzwingt ein Schema mit Meta-Titeln, Fokus-Keywords und FAQ-Einträgen. Indem diese Felder direkt aus dem Quellmaterial befüllt werden müssen, stellen wir sicher, dass SEO ein Nebenprodukt guter technischer Dokumentation ist und keine separate Marketingschicht, die die Fakten verzerrt. Stützt das Quellmaterial einen bestimmten FAQ-Eintrag nicht, nehmen wir ihn nicht auf. Lieber ein kürzeres, genaueres Dokument als ein langes, spekulatives. Das ist besonders wichtig bei der Erzeugung strukturierter Daten wie JSON. Die Ausgabe muss parsbar und valide sein und sich an die strikte Hierarchie der Quelle halten. Wir haben gesehen, wie die Vorhersagbarkeitslücke in modernen KI-Implementierungen Probleme verursacht; dasselbe gilt für die Datenextraktion. Erlaubt das Extraktions-Framework „lockeres“ JSON oder ein inkonsistentes Schema-Mapping, werden die nachgelagerten Systeme – ob LLMs oder klassische Datenbanken – früher oder später versagen. Das ist eine verbreitete Form von Wissensschulden, die sich mit der Zeit aufsummieren.
Umsetzungsdetails für technische Teams
Bei der Umsetzung dieses Frameworks empfehlen wir, Ihr Content-Repository wie eine Codebasis zu behandeln. Das bedeutet, Versionskontrolle (Git) für Ihre JSON-Quelldateien zu nutzen und automatisierte Linter laufen zu lassen, die nach verbotenen Begriffen oder falschen Datumsformaten suchen.
Umgang mit komplexem Quellmaterial
Enthält das Quellmaterial widersprüchliche Fakten, schreibt das Framework vor, den Widerspruch zu dokumentieren, statt ihn durch eine Annahme aufzulösen. Das ist der Unterschied zwischen einem Junior-Redakteur und einem erfahrenen Praktiker. Ein Junior-Redakteur wählt vielleicht die „wahrscheinlichste“ Zahl, damit sich der Text flüssiger liest. Ein erfahrener Praktiker vermerkt: „Quelle A gibt 100 ms Latenz an, Quelle B dagegen 150 ms“ – und bewahrt so die technische Realität für den Leser. Dieser Detailgrad ist entscheidend bei souveränen Stacks, bei denen technische Feinheiten über den Erfolg der gesamten Infrastruktur entscheiden. Wir haben Fälle erlebt, in denen das Ignorieren einer kleinen Einschränkung in der Extraktionsphase zu einem Szenario mit einem vergifteten Repository führte, weil Sicherheitswarnungen zugunsten „saubererer“ Texte entfernt worden waren.
Praktisches Extraktionsbeispiel
Stellen Sie sich ein Quelldokument vor, das ein neues API-Gateway beschreibt. Laut Quelle verarbeitet es 10.000 Anfragen pro Sekunde, hat aber ein Speicherleck bei Payloads über 5 MB. Eine vom Marketing getriebene Extraktion würde sich womöglich nur auf den Durchsatz von 10.000 konzentrieren. Unser Framework verlangt, dass die 5-MB-Einschränkung prominent erscheint. Wir behandeln die Einschränkung als Entität mit hoher Priorität. So hat der Ops-Verantwortliche, der die Zusammenfassung liest, dieselben kritischen Informationen wie der Engineer, der das 50-seitige Whitepaper gelesen hat.
Wann Sie dieses Framework für die Analyse und Extraktion technischer Inhalte nicht einsetzen sollten
Wir sind ehrlich, was Zielkonflikte angeht: Dieses Framework ist keine Universallösung. Sie sollten diesen Ansatz nicht verwenden für kreative Marketingtexte, Brand Storytelling oder visionäre Beiträge auf hoher Ebene, bei denen es darum geht zu inspirieren statt zu informieren. Das Framework ist für technische Dokumentation, Praxisnotizen zur Infrastruktur und operative Leitfäden konzipiert. Wenn Sie einen „viralen“ Social-Media-Beitrag schreiben wollen, der auf emotionale Auslöser statt auf datenbasierte Fakten setzt, steht Ihnen diese Strenge nur im Weg. Es ist ein Werkzeug für Präzision, nicht für Überzeugungsarbeit. Arbeiten Sie zudem mit einer Quelle, die absichtlich vage oder rein theoretisch ist und keine konkreten Datenpunkte enthält, führt das Hineinzwängen in dieses Framework wahrscheinlich zu einer sehr dünnen, wenig hilfreichen Ausgabe. Damit das Framework wirkt, braucht das Quellmaterial Substanz.
Die wichtigsten Erkenntnisse
- Quelltreue ist die wichtigste Kennzahl: Lassen Sie niemals zu, dass Markenstimme oder SEO-Ziele das faktische Rückgrat Ihres Quellmaterials überlagern.
- Auf europäische Einheiten standardisieren: Verwenden Sie ausschließlich metrische Einheiten (kg, m, °C) und das Format TT.MM.JJJJ, um grenzüberschreitende technische Fehler zu vermeiden.
- Die Persona eines erfahrenen Praktikers anwenden: Sprechen Sie auf Augenhöhe, vermeiden Sie Marketing-Klischees und seien Sie ehrlich zu den Grenzen der Tools, die Sie empfehlen.
- Strikte Ausgabeformatierung durchsetzen: Ob JSON oder Markdown – die Struktur muss parsbar und konsistent sein, um technische Schulden zu vermeiden.
- Unverzichtbare Fakten früh identifizieren: Isolieren Sie harte Datenpunkte, einzigartige Beispiele und technische Einschränkungen, bevor Sie mit dem Umschreiben beginnen.
Häufig gestellte Fragen
Warum verbieten Sie US-Einheiten wie Zoll und Meilen?
Im technischen Kontext bedeutet Konsistenz Sicherheit. Für europäische Unternehmen stellen metrische Einheiten sicher, dass alle – vom Engineering bis zum Betrieb – dieselbe Sprache sprechen, ohne manuell umrechnen zu müssen, was eine häufige Fehlerquelle ist. So werden Fehler vom Typ „Mars Climate Orbiter“ vermieden, bei denen falsch zugeordnete Einheiten zu katastrophalen Folgen führen.
Kann ich dieses Framework für Marketing-Blogs nutzen?
Nein. Dieses Framework wurde speziell für technische Inhalte entwickelt, bei denen faktische Genauigkeit und strukturelle Integrität wichtiger sind als „Lesefluss“ oder emotionale Bindung. Für Marketing ist ein flexiblerer Ansatz nötig, der Erzählbögen und aspirative Sprache zulässt.
Was passiert, wenn im Quellmaterial Daten fehlen?
Fehlen im Quellmaterial kritische Fakten, verlangt das Framework, die Lücke zu kennzeichnen, statt sie mit Annahmen zu füllen. Aus Sicht eines erfahrenen Praktikers ist es besser zu sagen: „Die Quelle nennt keine Latenz“, als eine Zahl zu raten. So bleibt die Integrität der Extraktion gewahrt.
Wie geht dieses Framework mit KI-generierten Inhalten um?
Dieses Framework dient als „Leitplanke“ für KI. Durch einen strikten Source Fidelity Contract und einen 12-stufigen Prozess verringern wir die Wahrscheinlichkeit von KI-Halluzinationen. Es zwingt das Modell, innerhalb der Grenzen der bereitgestellten Fakten zu bleiben – ähnlich wie ein Linter Code dazu zwingt, die Syntaxregeln einzuhalten. Um die Lücke zwischen Rohinformationen und nutzbaren technischen Inhalten zu schließen, müssen wir unser Verständnis von „Schreiben“ ändern. Wenn wir Inhalte als Problem der Datenextraktion statt als kreative Aufgabe behandeln, bauen wir Systeme, die zuverlässiger und leichter zu pflegen sind. Denken Sie bei der Verfeinerung Ihres eigenen Frameworks für die Analyse und Extraktion technischer Inhalte daran: Ihr Ziel ist nicht, dass die Inhalte besser klingen – sondern dass sie in Ihrem technischen Stack besser funktionieren.
Nächster Schritt
Nutzen Sie das Framework, bevor Sie technische Inhalte migrieren oder automatisieren. Sprechen Sie mit DataTip.