

W skrócie: Artykuł dowodzi, że AI przyspiesza pracę tylko wtedy, gdy wiedzę organizacji da się wyjaśnić i jest ona współdzielona. Gdy inżynierowie zostawiają przełomy, kompromisy i ludzkie korekty w prywatnych czatach, firmy gromadzą dług wiedzy, wielokrotnie dokonują tych samych odkryć i tworzą niemożliwy do utrzymania „magiczny kod”. Autorzy rekomendują potoki Agent-to-Knowledge, które automatycznie streszczają istotne rozmowy z AI we wspólnej dokumentacji, zachowując kontekst techniczny, wiedzę instytucjonalną i długoterminowe tempo pracy.
- Prywatne czaty z AI mogą wymazać uzasadnienie kluczowych decyzji technicznych i uniemożliwić przyszłym inżynierom uczenie się na nich.
- Wielokrotne rozwiązywanie tych samych problemów architektonicznych, ponieważ odkrycia nie są indeksowane, tworzy ukryty koszt R&D.
- Zautomatyzowane potoki Agent-to-Knowledge mogą streszczać zapisy czatów i publikować kompromisy techniczne w wewnętrznych repozytoriach.
- Ludzkie korekty w sytuacjach, gdy AI się myli, są szczególnie cennymi danymi do nauki i powinny być dokumentowane.
- Artykuł zaleca audyt logów czatów, tworzenie procesów ekstrakcji jednym kliknięciem i ochronę zastrzeżonej logiki poprzez zasady korzystania z AI.
Narzędzia AI mogą przyspieszyć tylko to, co organizacja potrafi wyjaśnić. Gdy kontekst żyje w czatach, głowach, nieaktualnych dokumentach i niewypowiedzianych założeniach, każde zadanie dla AI zaczyna się od spłaty długu wiedzy.
Starszy inżynier w firmie partnerskiej spędził niedawno cztery godziny na debugowaniu wyścigu (race condition) w systemie rozproszonym, zadając pytania modelowi LLM. Znalazł poprawkę, załatał kod i zamknął kartę. Logika stojąca za tą poprawką – to „dlaczego”, które zapobiega nawrotowi problemu – istnieje teraz wyłącznie w porzuconej historii czatu.
To jest kryzys długu wiedzy. W erze przed AI ten inżynier najpewniej przeszukałby Stack Overflow, znalazł częściową odpowiedź i być może podzielił się swoim nietypowym przypadkiem brzegowym ze społecznością lub w wewnętrznej wiki. Dziś ta pętla jest zamknięta i prywatna. Wymieniamy długoterminową inteligencję instytucjonalną na krótkoterminowe tempo pracy jednostek.
W DATATIP zauważyliśmy, że w miarę jak publiczny internet „cichnie”, wewnętrzna przewaga technologiczna większości firm również się ulatnia. Wiedza jest prywatyzowana, a potem natychmiast usuwana. Jeśli zespół polega na AI przy rozwiązywaniu nowych problemów, nie mając systemu do utrwalania wyników, traci nie tylko dane – traci zdolność kształcenia przyszłych seniorów.
Cicha erozja kontekstu technicznego
Przejście z publicznych forów do prywatnych interfejsów czatu stworzyło ogromny martwy punkt dla liderów technicznych. Gdy programista rozwiązuje problem z pomocą asystenta AI, artefakt odkrycia przepada. Najwyraźniej widać to w szybko rosnących zespołach inżynierskich, w których te same złożone pytania architektoniczne zadaje AI trzech różnych programistów w tym samym tygodniu.
Ponieważ rozwiązanie nie zostało zaindeksowane we wspólnym repozytorium, firma zapłaciła za to odkrycie trzy razy. Powielane rozwiązywanie problemów to ukryty podatek od budżetu R&D. Nie chodzi tylko o efektywność, lecz także o jakość bazy kodu. Bez kontekstu rozmowy z AI wynikowy pull request często wygląda jak „magiczny kod”, którego nikt nie potrafi utrzymywać.
„Największym ryzykiem wdrażania AI nie są halucynacje, lecz całkowita utrata tego, »jak« powstały najważniejsze decyzje techniczne”.
Wdrażanie potoków Agent-to-Knowledge
Nie wierzymy w walkę z korzystaniem z AI – wierzymy w obrócenie go na naszą korzyść. Aby przeciwdziałać długowi wiedzy, zmieniliśmy nasze wewnętrzne zasady: nasi inżynierowie mają teraz obowiązek traktować AI jako partnera badawczego, a nie tylko generator kodu. Oznacza to, że każdy istotny przełom osiągnięty w czacie musi zostać przeniesiony z powrotem do naszej wspólnej dokumentacji.
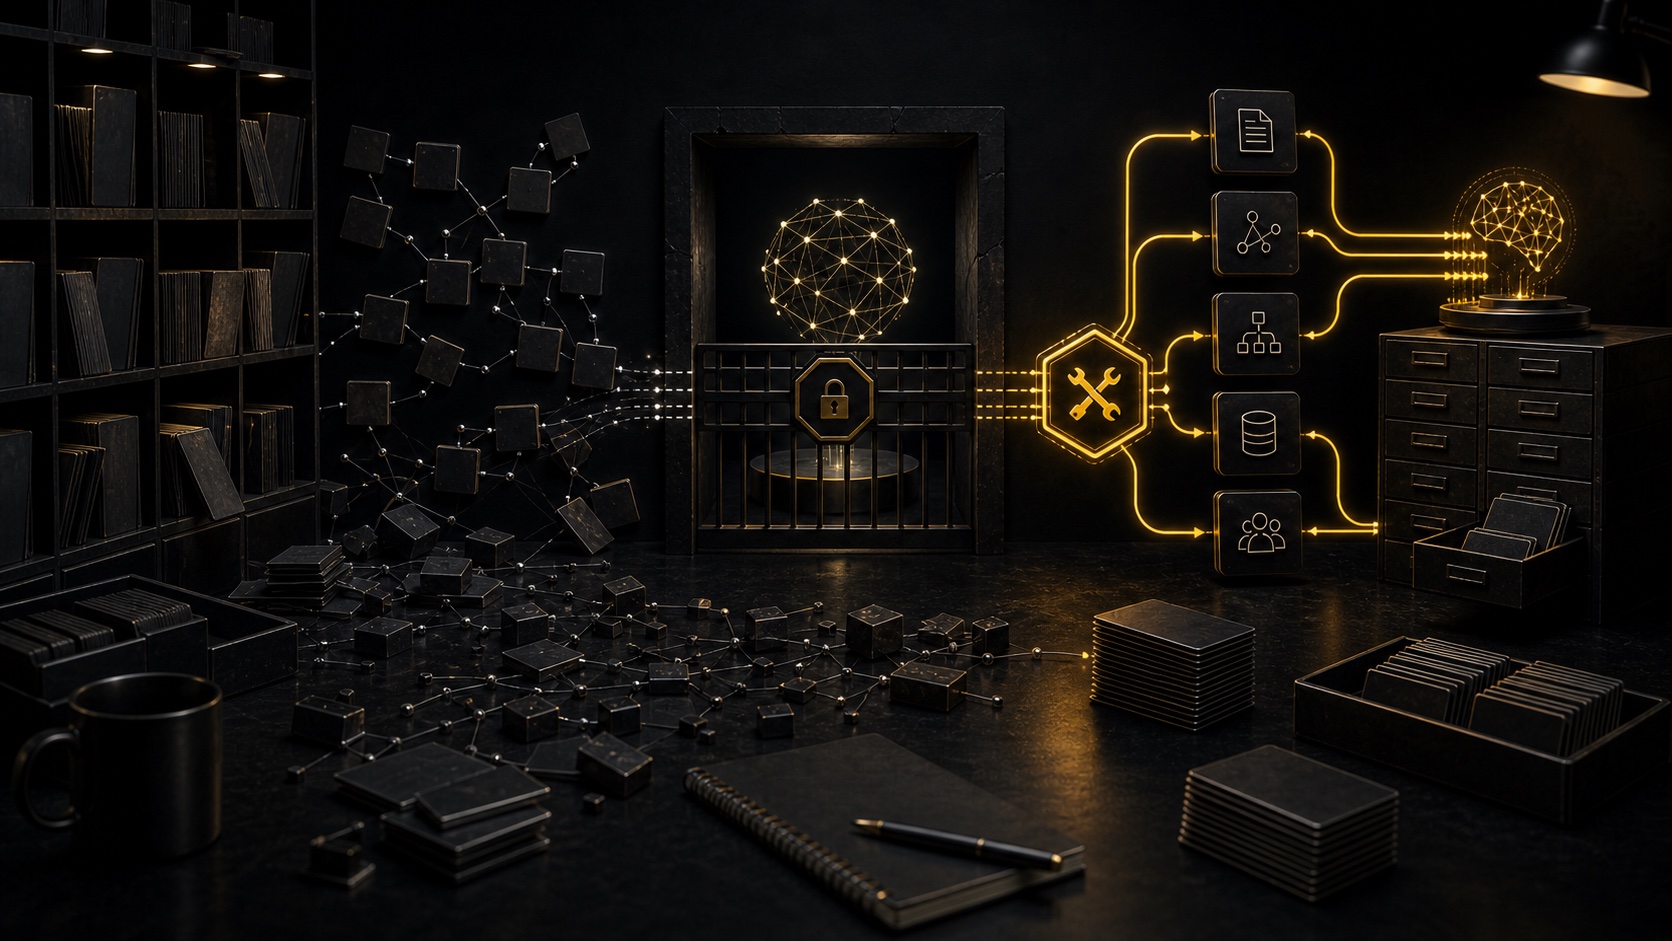
Wdrażamy coś, co nazywamy potokami Agent-to-Knowledge. Gdy inżynier dokona przełomu, korzysta ze standardowego narzędzia wewnętrznego, aby „wyeksportować” tok rozumowania. To nie jest ręczne kopiowanie i wklejanie. Używamy zautomatyzowanych skryptów, które pobierają zapis czatu, streszczają omawiane kompromisy techniczne i przesyłają je bezpośrednio do naszego podręcznika inżynierskiego lub GitHub Discussions.
Zanim zostanie otwarty pull request, kontekstowy rodowód rozwiązania jest już dostępny do wyszukania dla reszty zespołu. W ten sposób ulotny czat staje się trwałym zasobem. Szacujemy, że ta praktyka skraca czas „ponownego odkrywania” o 40% w przypadku złożonych integracji.
Dlaczego dane syntetyczne nie uratują zespołu
Powszechne jest błędne przekonanie, że przyszłe modele AI po prostu „będą wiedzieć”, jak rozwiązywać takie problemy, dzięki danym syntetycznym i samouczeniu. To niebezpieczne założenie dla liderów technicznych. Dane syntetyczne mogą zweryfikować, czy kod działa, ale nie wyjaśnią, dlaczego w konkretnym kontekście biznesowym wybrano jedną architekturę zamiast innej.
Prawdziwe przełomy często wynikają z „rzeczywistego tarcia” – momentów, w których AI się myliła, a człowiek musiał sprowadzić ją z powrotem na właściwy tor. To korygowanie kursu jest najcenniejszą informacją, jaką firma posiada. Bez utrwalania korekt kursu na linii człowiek–AI najcenniejsza własność intelektualna zostaje w rękach zewnętrznych dostawców LLM, którzy mogą – lub nie – wykorzystać ją do trenowania modeli dla konkurencji.
Kompromis: tempo a rzetelność
Zdajemy sobie sprawę z tego tarcia. Zatrzymanie się, by udokumentować przełom, wydaje się hamować tempo pracy. Znacznie szybciej jest po prostu wdrożyć kod i przejść do następnego zgłoszenia. Postrzegamy to jednak jako kompromis w zakresie długu technicznego. Można zaoszczędzić 15 minut dziś, pomijając dokumentację, albo zaoszczędzić 15 godzin w przyszłym miesiącu, gdy młodszy inżynier zepsuje ten sam system, bo nie zrozumiał pierwotnej logiki wypracowanej w czacie.
W DATATIP stawiamy rzetelność ponad samą szybkość. Przekonaliśmy się, że zespoły dokumentujące swoje przełomy z AI w horyzoncie sześciu miesięcy działają w rzeczywistości szybciej, ponieważ nie muszą bez przerwy gasić regresji wywołanych kodem AI działającym jak „czarna skrzynka”.
Najważniejsze wnioski
- Audyt logów czatów: warto ustalić, ile kluczowych decyzji architektonicznych jest obecnie uwięzionych w indywidualnych kontach AI.
- Standaryzacja ekstrakcji: warto stworzyć dla programistów ścieżkę „jednego kliknięcia”, która przenosi wnioski z AI do wspólnych wiki technicznych.
- Docenianie tarcia: momenty, w których AI miała trudności, to najcenniejsze okazje do nauki dla zespołu – należy je dokumentować w szczególny sposób.
- Ochrona własności intelektualnej: zasady korzystania z AI powinny zapobiegać wyciekowi zastrzeżonej logiki, a jednocześnie zapewniać jej utrwalanie wewnątrz firmy.
Najczęściej zadawane pytania
Jak zachęcić programistów do dokumentowania czatów z AI, nie spowalniając ich pracy?
Korzystamy z narzędzi do automatycznego streszczania, które na podstawie surowego logu czatu generują szkic notatki technicznej. Programista musi jedynie poświęcić dwie minuty na przegląd i kliknąć „opublikuj” w naszej wewnętrznej bazie wiedzy.
Czy publiczny internet nie zawiera już wystarczająco dużo informacji do trenowania AI?
Nie. Internet staje się pętlą sprzężenia zwrotnego treści generowanych przez AI. Oryginalne przełomy osiągnięte pod kierunkiem ludzi stają się coraz rzadsze i cenniejsze; firma, która nie utrwala własnych, traci przewagę konkurencyjną.
Jakie narzędzia zalecamy do utrwalania wiedzy z AI?
Zalecamy narzędzia, które integrują się bezpośrednio z IDE lub CLI. Systemy takie jak GitHub Copilot for Business czy własne serwery MCP (Model Context Protocol) mogą pomóc wypełnić lukę między prywatnym czatem a publiczną dokumentacją.
Nowoczesne zespoły inżynierskie doświadczają obecnie ogromnego wycieku wiedzy instytucjonalnej do prywatnych historii czatów z AI; jedynym sposobem na zatamowanie tego wycieku jest budowanie kultury aktywnego wydobywania wiedzy.
Następny krok
Przed skalowaniem korzystania z AI warto sprawdzić, jakiego kontekstu potrzebują narzędzia AI. Porozmawiaj z DataTip.