

W skrócie: Artykuł dowodzi, że treści techniczne tracą wartość, gdy ekstrakcja usuwa ograniczenia, jednostki, zastrzeżenia i intencję źródła. Rekomenduje ścisły, podobny do pracy z kodem proces: zachowanie kolejności argumentów i twardych faktów, standaryzację jednostek i dat, usunięcie języka marketingowego, pokazanie kompromisów, dokumentowanie sprzeczności i walidację ustrukturyzowanego wyniku. Podejście sprawdza się w dokumentacji technicznej i przewodnikach operacyjnych, ale nie w treściach kreatywnych ani czysto inspiracyjnym marketingu.
- Należy chronić wierność źródłu: nie wymyślać twierdzeń, nie uzupełniać luk w danych i nie pozwalać, by SEO czy głos marki przeważyły nad faktami.
- Ograniczenia, zastrzeżenia, jednostki, nazwy własne i unikalne przykłady należy traktować priorytetowo jako informacje obowiązkowe do zachowania.
- Warto stosować jednostki metryczne, daty w formacie DD.MM.RRRR, spójne schematy, poprawny JSON, kontrolę wersji i automatyczny linting.
- Gdy źródła są sprzeczne, należy udokumentować oba twierdzenia, zamiast rozstrzygać rozbieżności na podstawie założeń.
- Framework jest przeznaczony do treści technicznych i operacyjnych, a nie do kreatywnego marketingu, storytellingu marki czy mglistych materiałów teoretycznych.
Treści techniczne stają się kosztowne, gdy podczas ekstrakcji giną ograniczenia, jednostki, przypadki brzegowe i intencja źródła. Traktowanie treści jak kodu nie jest tu metaforą; to sposób na utrzymanie niezawodności systemów, które z nich korzystają.
12-etapowy proces ekstrakcji
- Czytanie pod kątem tezy: Należy zidentyfikować główny argument techniczny bez dodawania zewnętrznych interpretacji.
- Mapowanie kolejności argumentów: Należy zachować logiczny tok myślenia autora, aby nie naruszyć spójności wywodu.
- Wyodrębnienie twardych faktów: Należy wyodrębnić liczby, konkretne produkty i nazwy własne. Jeśli źródło podaje 50 ms, wynik również podaje 50 ms.
- Identyfikacja ograniczeń: Należy odnotować, czego system nie potrafi. W dokumentacji technicznej zastrzeżenia są ważniejsze niż funkcje.
- Audyt jednostek: Jednostki niemetryczne należy od razu przeliczać na m, kg lub °C. Jeśli źródło wspomina 10 mil, przelicza się to na 16 km.
- Filtrowanie szumu marki: Należy usunąć marketingowe wypełniacze źródła. Jeśli źródło nazywa coś „rewolucyjnym”, sprowadzamy to do opisu funkcjonalnego.
- Lokalizacja: Daty muszą mieć format DD.MM.RRRR, a zapis walut powinien unikać symboli specyficznych dla USA.
- Dopasowanie persony: Pozostałe fakty należy przepisać głosem „doświadczonego praktyka” – bezpośrednio i jak równy z równym.
- Dodanie kompromisów: Należy jasno określić przypadek „kiedy nie stosować” na podstawie ograniczeń źródła.
- Sprawdzenie linków wewnętrznych: Warto dodać kontekstowo trafne linki do powiązanych koncepcji inżynierskich, takich jak suwerenne stosy technologiczne.
- Weryfikacja integralności JSON: Należy upewnić się, że spełniono wszystkie wymagania dotyczące metadanych i schematu, aby wynik dał się sparsować.
- Końcowa weryfikacja wierności: Należy porównać wersję roboczą ze źródłem, aby upewnić się, że nie wymyślono nowych twierdzeń, wskaźników ROI ani wielkości zespołów.
Analizując źródło, trzeba zidentyfikować unikalne twierdzenia i przykłady, które stanowią o jego wartości. Jeśli na przykład artykuł techniczny podaje konkretne opóźnienie 50 ms, ta liczba jest faktem „obowiązkowym do zachowania”. Nie pozwalamy, by głos marki łagodził te twarde techniczne szczegóły. Jak pisaliśmy w artykule o zarządzaniu wąskim gardłem produktywności AI, celem jest usunięcie tarcia między danymi źródłowymi a finalną implementacją.
Wierność i wymagania dotyczące wyniku
Wierność w tym frameworku oznacza, że faktograficzny kręgosłup źródła jest chroniony przed „kreatywnymi” zapędami autora lub modelu. Aby to egzekwować, stosujemy kontrakt wierności źródłu. Zgodnie z nim, jeśli wytyczne marki wymagają rezultatu biznesowego, którego nie ma w źródle, rezygnujemy z tego wymogu. Nie wymyślamy. Nie dopychamy treści.
JSON jako ostateczne źródło prawdy
W tym frameworku wynik w formacie JSON jest „źródłem prawdy” dla systemu publikacji. Wymusza schemat obejmujący meta tytuły, słowa kluczowe i elementy FAQ. Wymagając, by pola te były uzupełniane bezpośrednio na podstawie materiału źródłowego, sprawiamy, że SEO jest produktem ubocznym dobrej dokumentacji technicznej, a nie osobną warstwą marketingową zniekształcającą fakty. Jeśli materiał źródłowy nie uzasadnia danego pytania w FAQ, nie uwzględniamy go. Wolimy krótszy, dokładniejszy dokument niż długi i spekulatywny.
Jest to szczególnie ważne przy generowaniu danych ustrukturyzowanych, takich jak JSON. Wynik musi być poprawny i dawać się sparsować, zgodnie ze ścisłą hierarchią źródła. Widzieliśmy, jak luka przewidywalności powoduje problemy we współczesnych wdrożeniach AI; to samo dotyczy ekstrakcji danych. Jeśli framework ekstrakcji dopuszcza „luźny” JSON lub niespójne mapowanie schematu, systemy korzystające z wyników – czy to LLM, czy tradycyjne bazy danych – w końcu zawiodą. To częsta forma długu wiedzy, który z czasem narasta.
Szczegóły wdrożenia dla zespołów technicznych
Wdrażając ten framework, rekomendujemy traktowanie repozytorium treści jak bazy kodu. Oznacza to korzystanie z kontroli wersji (Git) dla źródłowych plików JSON i uruchamianie automatycznych linterów sprawdzających zakazane sformułowania lub nieprawidłowe formaty dat.
Praca ze złożonym materiałem źródłowym
Jeśli materiał źródłowy zawiera sprzeczne fakty, framework wymaga udokumentowania sprzeczności zamiast rozstrzygania jej założeniem. Na tym polega różnica między młodszym redaktorem a doświadczonym praktykiem. Młodszy redaktor mógłby wybrać „najbardziej prawdopodobną” liczbę, by tekst lepiej się czytał. Doświadczony praktyk odnotowuje, że „źródło A podaje opóźnienie 100 ms, a źródło B 150 ms”, zachowując techniczną rzeczywistość dla czytelnika.
Taki poziom szczegółowości jest kluczowy w przypadku suwerennych stosów technologicznych, gdzie techniczne niuanse decydują o powodzeniu całej infrastruktury. Widzieliśmy przypadki, w których pominięcie drobnego ograniczenia na etapie ekstrakcji doprowadziło do scenariusza zatrutego repozytorium, ponieważ ostrzeżenia bezpieczeństwa usunięto na rzecz „czystszego” tekstu.
Praktyczny przykład ekstrakcji
Wyobraźmy sobie dokument źródłowy opisujący nową bramę API. Źródło podaje, że obsługuje ona 10 000 żądań na sekundę, ale ma wyciek pamięci przy przetwarzaniu ładunków powyżej 5 MB. Ekstrakcja prowadzona przez marketing mogłaby skupić się wyłącznie na przepustowości 10 tys. Nasz framework wymaga, by ograniczenie 5 MB było wyraźnie wyeksponowane. Traktujemy je jako element o wysokim priorytecie. Dzięki temu osoba odpowiedzialna za operacje, czytając podsumowanie, ma te same kluczowe informacje co inżynier, który przeczytał 50-stronicowy whitepaper.
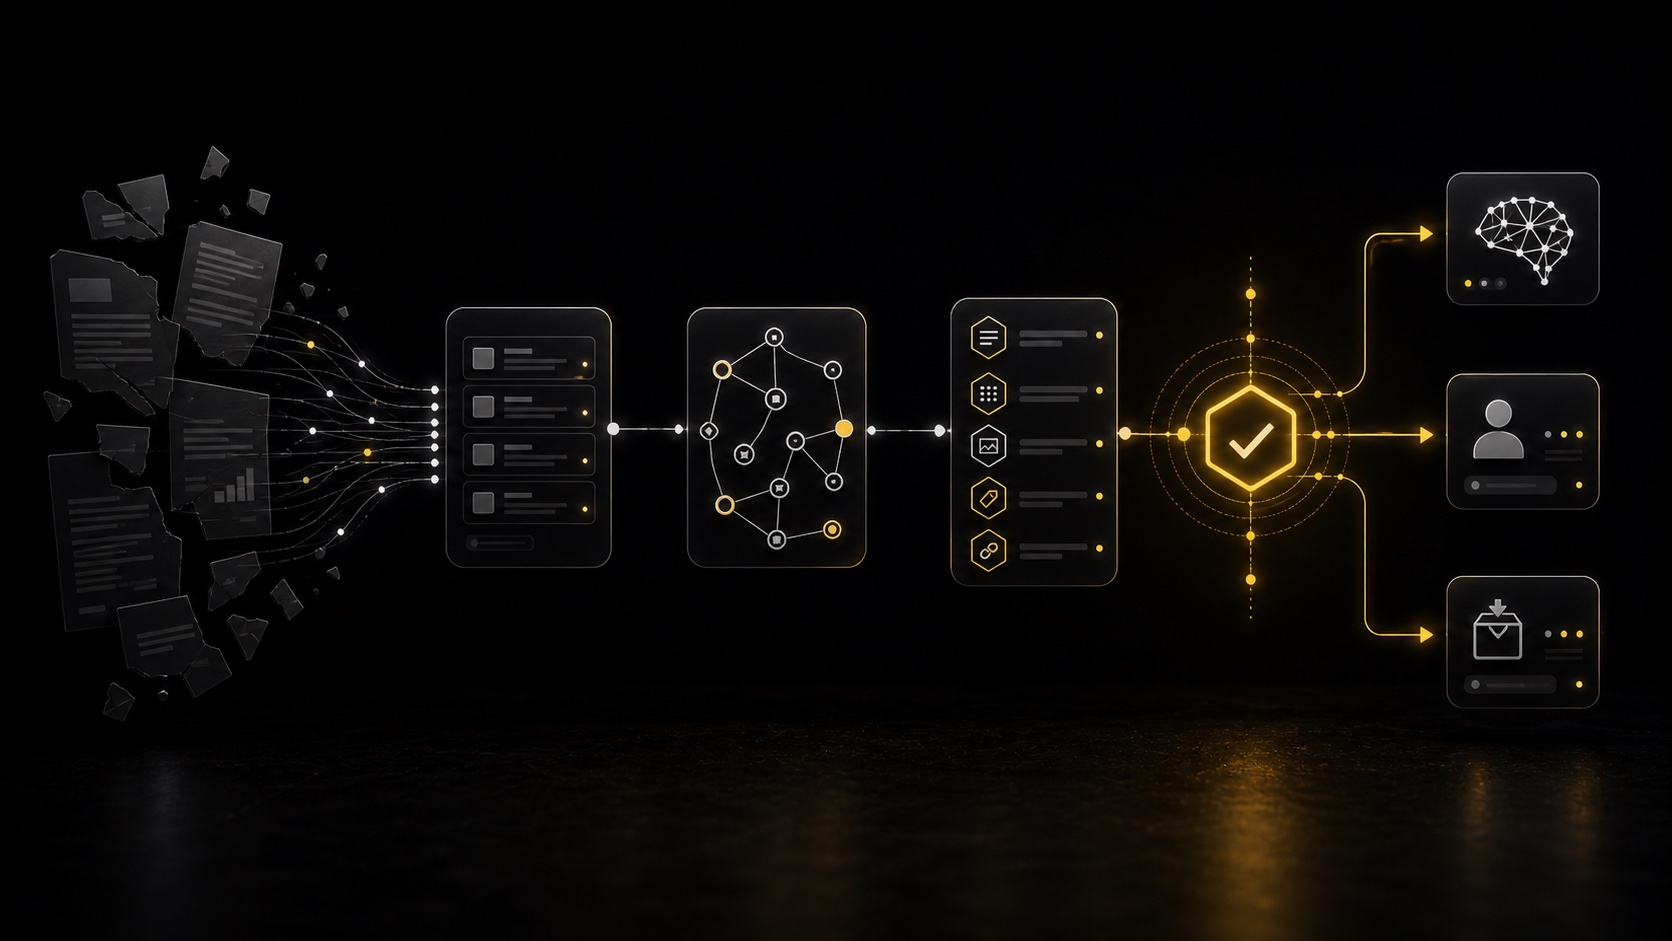
Kiedy nie stosować tego frameworku analizy i ekstrakcji treści technicznych
Uczciwie mówimy o kompromisach: ten framework nie jest rozwiązaniem uniwersalnym. Nie należy stosować tego podejścia do kreatywnych tekstów marketingowych, storytellingu marki ani wizjonerskich tekstów, których celem jest inspirować, a nie informować. Framework jest przeznaczony do dokumentacji technicznej, notatek terenowych z infrastruktury i przewodników operacyjnych.
Jeśli celem jest napisanie „wiralowego” posta w mediach społecznościowych, który opiera się na emocjach, a nie na faktach popartych danymi, taki rygor będzie tylko przeszkadzał. To narzędzie do precyzji, a nie do perswazji. Co więcej, jeśli źródło jest celowo mgliste lub czysto teoretyczne, bez konkretnych danych, wtłoczenie go w ten framework najpewniej da bardzo ubogi, mało przydatny wynik. Aby framework był skuteczny, materiał źródłowy musi mieć konkretną treść.
Najważniejsze wnioski
- Wierność źródłu to główna miara: Nigdy nie należy pozwalać, by głos marki lub cele SEO przeważyły nad faktograficznym kręgosłupem materiału źródłowego.
- Standaryzacja na jednostki europejskie: Należy stosować wyłącznie jednostki metryczne (kg, m, °C) i format DD.MM.RRRR, aby uniknąć błędów technicznych w komunikacji międzynarodowej.
- Persona doświadczonego praktyka: Warto mówić jak równy z równym, unikać marketingowych frazesów i uczciwie przedstawiać ograniczenia rekomendowanych narzędzi.
- Ścisłe formatowanie wyniku: Niezależnie od tego, czy to JSON, czy Markdown, struktura musi być spójna i dawać się sparsować, aby nie narastał dług techniczny.
- Wczesna identyfikacja faktów „obowiązkowych”: Twarde dane, unikalne przykłady i ograniczenia techniczne należy wyodrębnić przed rozpoczęciem przepisywania.
Najczęściej zadawane pytania
Dlaczego zakazujecie amerykańskich jednostek, takich jak cale i mile?
W kontekście technicznym spójność oznacza bezpieczeństwo. W europejskich firmach jednostki metryczne sprawiają, że wszyscy – od inżynierii po operacje – mówią tym samym językiem bez ręcznego przeliczania, które jest częstym źródłem błędów. Zapobiega to awariom w rodzaju „Mars Climate Orbiter”, gdzie niezgodność jednostek doprowadziła do katastrofalnych skutków.
Czy można używać tego frameworku do blogów marketingowych?
Nie. Ten framework powstał specjalnie dla treści technicznych, w których dokładność faktów i spójność struktury są ważniejsze niż „płynność” czy zaangażowanie emocjonalne. Marketing wymaga bardziej elastycznego podejścia, które dopuszcza łuki narracyjne i język aspiracyjny.
Co się dzieje, gdy w materiale źródłowym brakuje danych?
Jeśli w materiale źródłowym brakuje kluczowych faktów, framework wymaga zasygnalizowania luki zamiast wypełniania jej założeniami. Z perspektywy doświadczonego praktyka lepiej napisać „źródło nie podaje opóźnienia”, niż zgadywać liczbę. Pozwala to zachować integralność ekstrakcji.
Jak ten framework radzi sobie z treściami generowanymi przez AI?
Framework działa jak „bariera ochronna” dla AI. Dzięki ścisłemu kontraktowi wierności źródłu i 12-etapowemu procesowi zmniejszamy prawdopodobieństwo halucynacji AI. Wymusza on na modelu pozostanie w granicach dostarczonych faktów – podobnie jak linter wymusza na kodzie zgodność z regułami składni.
Zamknięcie luki między surowymi informacjami a użyteczną treścią techniczną wymaga zmiany sposobu myślenia o „pisaniu”. Traktując treść jako problem ekstrakcji danych, a nie zadanie kreatywne, budujemy systemy bardziej niezawodne i łatwiejsze w utrzymaniu. Dopracowując własny framework analizy i ekstrakcji treści technicznych, warto pamiętać, że celem nie jest sprawić, by treść lepiej brzmiała – lecz by lepiej działała w Państwa stosie technologicznym.
Następny krok
Warto zastosować ten framework przed migracją lub automatyzacją treści technicznych. Kontakt z DataTip.