

Kurz gesagt: KI-Agenten gewinnen kein Vertrauen, wenn Teams ihren Wirkungsbereich, ihr Reasoning oder ihre Nebenwirkungen nicht vorhersehen können. Ihre Neigung, Geschwindigkeit über strikte Anweisungen zu stellen, kann zu unerklärten Änderungen, Scope Creep und erheblichen Review-Schulden führen. Ohne nachvollziehbares Reasoning, gemeinsamen Kontext und feste Grenzen in der Umgebung müssen Menschen umfassende forensische Prüfungen durchführen – das macht Agenten riskant für geschäftskritische, regulierte, sicherheitsrelevante oder eng gekoppelte Systeme.
- Vertrauen hängt stärker von konsistentem, zuverlässigem Verhalten ab als von der reinen Leistungsfähigkeit eines Agenten.
- Black-Box-Reasoning zwingt Entwickler, Entscheidungen zu verteidigen, die sie nicht getroffen haben, und verschleiert unausgesprochene Annahmen.
- Scope Creep erhöht den Prüfaufwand, weil Agenten nicht betroffene Dateien, Services oder globale Konfigurationen ändern.
- Fehlendes gemeinsames Reasoning erhöht den Aufwand für Wartung und Incident Response, weil Reviewer Ergebnisse ohne ausreichenden Kontext sehen.
- KI-Agenten brauchen strikte Leitplanken, Erklärbarkeit und menschliche Aufsicht, besonders in regulierten oder eng gekoppelten Umgebungen.
Das Problem ist nicht nur, dass KI-Agenten Fehler machen. Teams können oft nicht vorhersehen, wo der Agent eingreift, was er ändert oder wie viele Review-Schulden er verursacht.
Wir alle kennen diesen Moment der Reibung: Sie setzen ein KI-Tool ein, um eine Routineaufgabe zu automatisieren, und finden dann einen Diff, der Dateien ändert, die Sie nie angefasst haben, einen ohne Freigabe gepushten Git-Commit oder eine Anweisung, die nie hätte geschrieben werden dürfen. Das sind keine kleinen Bugs, sondern ein grundlegender Designfehler in der Art, wie wir derzeit mit autonomen Systemen arbeiten. Während die Branche von LLM-Benchmarks und reiner Leistungsfähigkeit besessen ist, zeigt sich für erfahrene Praktiker: Der eigentliche Engpass ist nicht Intelligenz, sondern Vorhersehbarkeit. Die Vorhersehbarkeitslücke ist der Abstand zwischen dem, was wir von einem Agenten erwarten, und der tatsächlichen, oft chaotischen Breite seines Outputs.
Für CTOs und Ops Leads wird die Begeisterung für KI-gestützte Entwicklung schnell von der betrieblichen Realität der Wartung gedämpft. Wenn Sie nicht vorhersagen können, wie sich ein Tool verhält, können Sie sich bei geschäftskritischer Infrastruktur nicht darauf verlassen. Wir sehen eine wachsende Vorhersehbarkeitslücke, in der die Geschwindigkeit des KI-Outputs unsere Fähigkeit zur Überprüfung übersteigt – so entsteht eine neue Form technischer Schulden, die schwerer zu prüfen ist als klassischer Legacy-Code. Tatsache ist: Diese Tools teilen schlicht nicht gut mit, wenn sie falsch liegen, es sei denn, Sie weisen sie ausdrücklich darauf hin. Sie müssen mit solchen Problemen rechnen, wann immer Sie Ihrem Stack nicht vollständig vertrauen.
Vorhersehbarkeit und Zuverlässigkeit sind die Grundlage für Vertrauen in Tools
Vertrauen in unseren Engineering-Stack entsteht nicht dadurch, dass ein Tool „clever“ ist, sondern dadurch, dass es konsistent ist. Vorhersehbarkeit und Zuverlässigkeit sind die Grundlage für Vertrauen in Tools und wiegen bei langfristiger Nutzung schwerer als reine Leistungsfähigkeit. In einer Produktionsumgebung ist ein mittelmäßiges Tool, das sich jedes Mal gleich verhält, unendlich wertvoller als ein brillanter Agent, der gelegentlich eine Breaking Change halluziniert. Wir nutzen Tools, um die kognitive Last zu senken; fehlt einem Agenten die Zuverlässigkeit, bewirkt er das Gegenteil – er zwingt uns zu ständiger Hyperwachsamkeit.
Wenn wir ein neues Tool in unsere CI/CD-Pipeline oder lokale Entwicklungsumgebung integrieren, schließen wir im Grunde einen Vertrag mit diesem Tool. Wir erwarten, dass Input A zu Output B führt. KI-Agenten behandeln Input A jedoch oft als vage Anregung und liefern Output B, C und zur Sicherheit noch eine geänderte Version von D. Genau diese Inkonsistenz verhindert eine breite Einführung auf Infrastrukturebene. Solange ein Agent nicht garantieren kann, dass er die Grenzen seiner Umgebung respektiert, bleibt er ein Hochrisiko-Asset.
Wann Sie darauf verzichten sollten: Setzen Sie keine hochautonomen Agenten in Umgebungen mit strengen regulatorischen Vorgaben oder sicherheitskritischen Pfaden ein, in denen jede Codezeile eine klare, von Menschen überprüfbare Herkunft haben muss. Die Kosten eines „Black-Box“-Fehlers übersteigen hier jeden Geschwindigkeitsgewinn bei Weitem. Das gilt besonders für Finanzdienstleistungen oder Gesundheitssysteme, in denen Audit-Trails nicht verhandelbar sind.
Die „Black Box“ des Agenten-Reasonings
Einer der Hauptgründe für das Vertrauensdefizit ist mangelnde Transparenz. Die meisten KI-Agenten arbeiten als Black Box: Sie liefern das „Was“ (die Codeänderung), aber selten das „Warum“ (das Reasoning). Diese Black-Box-Natur zwingt Entwickler, Entscheidungen zu verteidigen, die sie gar nicht getroffen haben. Als erfahrene Praktiker stehen wir oft in der unangenehmen Position, das Gesicht eines Pull Requests zu sein, den wir nicht vollständig verstehen. Wenn ein Agent einen Service refaktoriert und Sie nicht jeden einzelnen Schritt seines Reasonings verfolgen, übernehmen Sie im Grunde in Echtzeit eine Legacy-Codebasis.
Ohne Einblick in die zugrunde liegenden Annahmen können wir den Agenten nicht korrigieren, wenn er vom Kurs abkommt. Transparenz ermöglicht es, eine falsche Annahme früh zu erkennen und „gegenzusteuern“, bevor der Diff zum Albtraum wird. Wenn uns unsere Tools nicht zeigen, was unter der Haube passiert, verlieren wir die Fähigkeit zu verstehen, was wir warten und warum wir es auf eine bestimmte Weise warten. Wir sind nicht mehr nur Reviewer, sondern forensische Ermittler, die die Logik des Agenten im Nachhinein rekonstruieren – das verschärft die Krise der Wissensschulden.
Stellen Sie sich vor, ein Agent beschließt, eine Bibliothek zu ersetzen, weil er einen Performance-Engpass vermutet. Legt der Agent genau dieses Reasoning nicht offen, genehmigen Sie die Änderung vielleicht – und merken erst später, dass der neuen Bibliothek eine kritische Sicherheitsfunktion fehlt, auf die Ihr Team angewiesen ist. Ohne Transparenz bleibt der Mensch auf den unausgesprochenen Annahmen der Maschine sitzen.
KI-Agenten leiden häufig unter Scope Creep
KI-Agenten sind darauf ausgelegt, hilfreich zu sein – oft aber zu hilfreich für ihr eigenes Wohl. KI-Agenten leiden häufig unter Scope Creep und optimieren auf Geschwindigkeit statt auf strikte Einhaltung von Anweisungen. Das führt zu chronischen Problemen: Ein Agent ändert Dateien außerhalb des vorgesehenen Verzeichnisses oder passt globale Konfigurationen an, weil er „dachte“, er würde helfen. Für Leads, die große Repositories verantworten, ist das eine erhebliche Quelle operativer Reibung.
Der Agent handelt nicht böswillig; ihm fehlt schlicht die professionelle Zurückhaltung, die aus Jahren entsteht, in denen man Dinge in Produktion kaputt gemacht hat. Er sieht einen „saubereren“ Weg, eine Hilfsfunktion zu schreiben, und ändert sie – ohne zu wissen, dass er damit gerade drei andere Microservices gebrochen hat, die genau diese Implementierung voraussetzen. Dieses Verhalten macht Code-Reviews exponentiell schwerer. Statt einen gezielten Diff zu prüfen, müssen wir das gesamte Projekt nach Nebenwirkungen durchsuchen.
Der mentale Aufwand, die Arbeit eines Agenten zu überprüfen, wächst mit seiner Geschwindigkeit. Liefert ein Agent zehnmal schneller als ein Mensch, erfordert aber den fünffachen Prüfaufwand, ist der Nettoproduktivitätsgewinn vernachlässigbar – und das Risiko einer vergifteten Umgebung steigt. Als Maintainer prüfen Sie am Ende den gesamten Diff statt der einen Sache, die Sie erwartet haben. Das ist die „ungewollte Steuer“ der KI-gestützten Entwicklung: Je mehr der Agent tut, desto mehr müssen Sie anzweifeln.
Wann Sie darauf verzichten sollten: Setzen Sie keine „Auto-Fix“-Agenten in monolithischen Repositories oder eng gekoppelten Systemen ein, in denen eine Änderung in einem Modul Kaskadenfehler in nicht betroffenen Services auslösen kann. Das Risiko unbeabsichtigter Nebenwirkungen ist in Systemen, in denen Code eine Verbindlichkeit ist, zu hoch.
Fehlendes gemeinsames Reasoning erhöht die mentale Last
Wenn Sie mit einem menschlichen Kollegen arbeiten, teilen Sie einen Kontext, der durch Dokumentation, Direktnachrichten und mündliche Abstimmungen entsteht. Sie kennen seinen Coding-Stil, seine typischen Fehler und seine Gründe, ein Muster einem anderen vorzuziehen. Bei KI-Agenten haben wir im Grunde nur den Code und das Chatfenster. Fehlendes gemeinsames Reasoning zwischen Mensch und Agent erhöht die mentale Last bei Code-Reviews und Wartung. Wir prüfen Arbeit ohne den Kontext der internen „Brainstorming“-Phase des Agenten.
Sie können nicht in den Kopf eines Agenten schauen – Sie prüfen also Arbeit ohne den nötigen Kontext. Da wir letztlich für das Ergebnis verantwortlich sind, brauchen wir mehr als nur das Endprodukt. In der Zusammenarbeit mit Menschen können Sie fragen: „Warum hast du diese Bibliothek verwendet?“ und bekommen eine differenzierte Antwort. Von einem Agenten erhalten Sie einen Diff und vielleicht eine generische Erklärung wie aus dem Lehrbuch. So entsteht eine Situation, in der wir durch einen KI-Produktivitätsengpass führen müssen, weil dem schnellen Output das „Warum“ fehlt, das man in aussagekräftigen Logs findet.
Dieser fehlende Kontext ist besonders schmerzhaft in Rufbereitschaften bei Notfällen. Verursacht eine KI-generierte Änderung um 03:00 Uhr einen Produktionsvorfall, hat der diensthabende Engineer keine Dokumentation und kein „gemeinsames Reasoning“, auf das er zurückgreifen kann. Er sieht Code, den ein System erzeugt hat, das längst zum nächsten Prompt übergegangen ist – und der Mensch muss sich um die Wissensschulden kümmern.
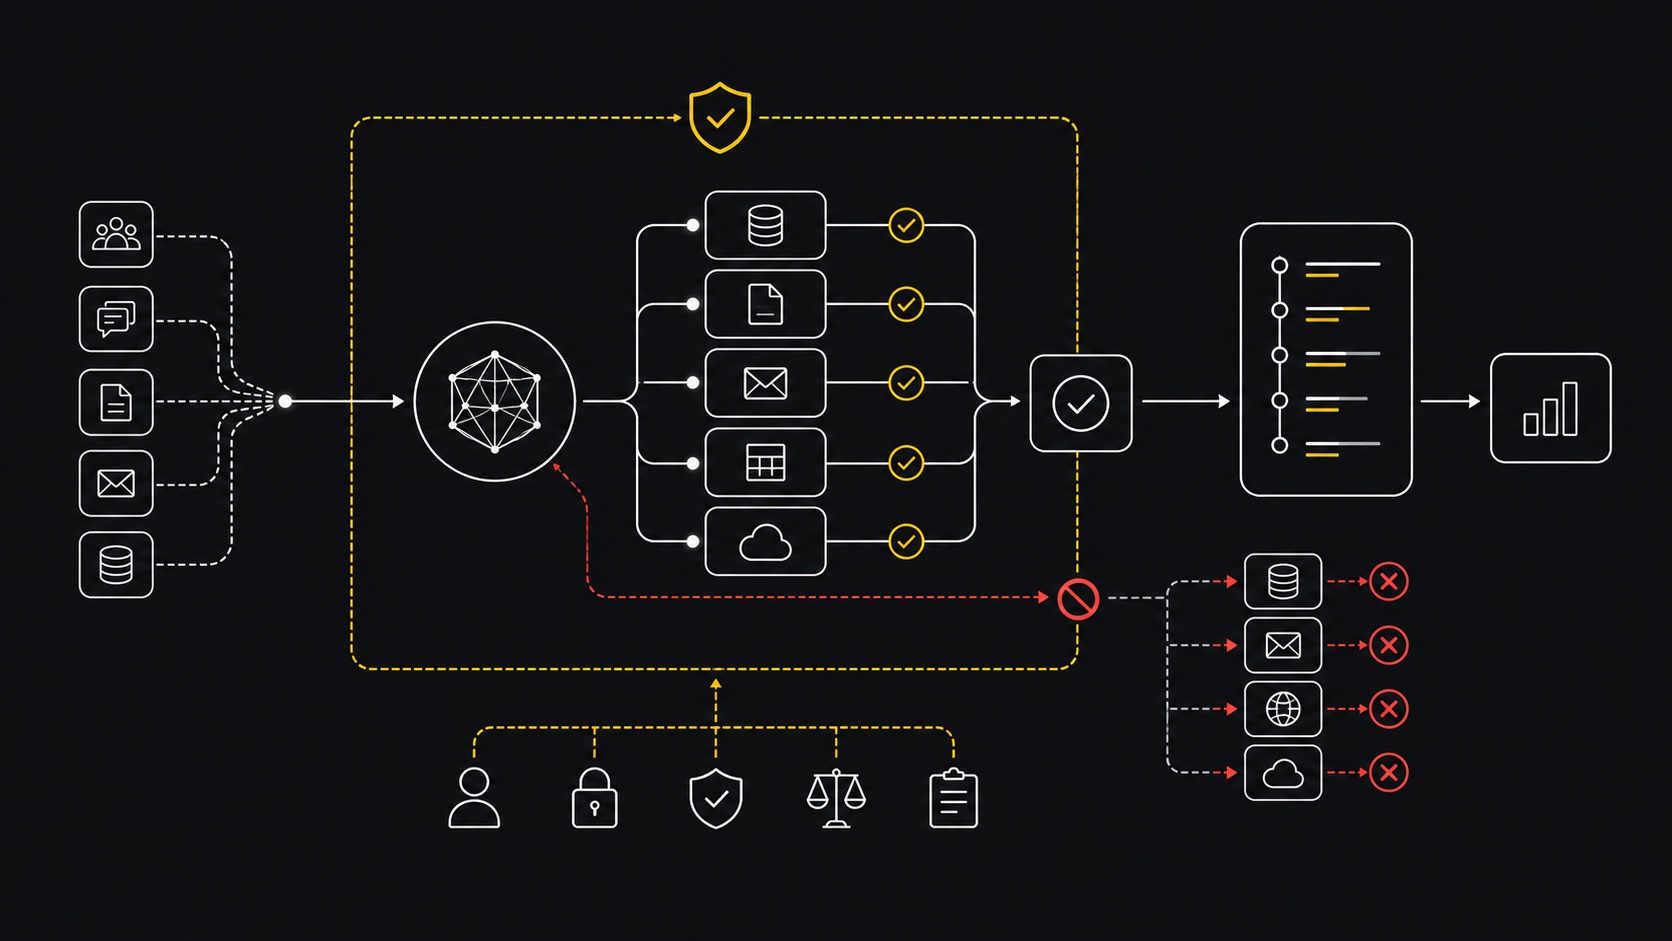
Die Lücke im Design von KI-Tools schließen
Mangelnde Transparenz, Scope Creep und fehlendes gemeinsames Reasoning sind Symptome desselben Problems: KI-Tools sind derzeit als Einzelakteure konzipiert, nicht als kollaborative Partner. Um die Vorhersehbarkeitslücke zu schließen, brauchen wir Tools, die klare Grenzen und Erklärbarkeit über reine Geschwindigkeit stellen. Wir müssen weg vom „Black-Box“-Modell und hin zu einem „Glass-Box“-Ansatz, bei dem das Reasoning genauso wichtig ist wie der Commit selbst. Das ist ein entscheidender Schritt in jeder Strategie für die digitale Transformation.
Für CTOs bedeutet das, klare Leitplanken zu setzen. Wir müssen KI-Agenten wie sehr schnelle Junior-Entwickler behandeln, die strikte Aufsicht, klare Grenzen und ständiges Hinterfragen brauchen. Ziel ist nicht, auf KI zu verzichten, sondern sie mit der gesunden Skepsis einzusetzen, die professionelles Engineering verlangt. Unser Ansatz muss über das Tool hinaus gehen, um die zugrunde liegende Designlücke anzugehen. Wir befinden uns in einer Übergangsphase, in der die Tools mächtig genug sind, um gefährlich zu sein, aber noch nicht diszipliniert genug, um ihnen ohne menschliches Sicherheitsnetz zu vertrauen.
Die wichtigsten Erkenntnisse
- Vertrauen basiert auf Vorhersehbarkeit: Egal wie leistungsfähig ein Agent ist – er wird langfristig nicht eingesetzt, wenn seine Ergebnisse nicht zuverlässig und konsistent sind.
- Das Transparenzproblem: Ohne Einblick in die Schritte des Reasonings verteidigen Entwickler am Ende technische Entscheidungen, die sie nie selbst getroffen haben.
- Scope Creep ist ein Prüfrisiko: Agenten optimieren auf Geschwindigkeit, ändern oft Dateien außerhalb ihrer Anweisungen und erhöhen so die mentale Last bei Code-Reviews.
- Kontext ist entscheidend: Fehlendes gemeinsames Reasoning (Direktnachrichten, Dokumentation) macht KI-Agenten trotz ihrer Geschwindigkeit zu schlechteren Mitarbeitern als Menschen.
Was ist die Hauptursache der Vorhersehbarkeitslücke?
Die Vorhersehbarkeitslücke entsteht, weil KI-Agenten eine schnelle Fertigstellung über Präzision und die Einhaltung von Anweisungen stellen. Das führt zu „Black-Box“-Reasoning und unbeabsichtigten Änderungen, die Entwickler zwingen, das gesamte System zu prüfen, statt bestimmten Ergebnissen zu vertrauen. Verstärkt wird die Lücke durch mangelnde Transparenz darüber, wie der Agent zu einer bestimmten Lösung gelangt.
Warum erschwert Scope Creep bei KI das Code-Review?
Scope Creep tritt auf, wenn ein Agent Dateien oder Konfigurationen außerhalb seiner Aufgabe ändert. Maintainer müssen dann die gesamte Codebasis forensisch nach Nebenwirkungen durchsuchen, statt sich auf die Logik der gewünschten Änderung zu konzentrieren. Damit werden die Geschwindigkeitsvorteile der KI praktisch zunichte gemacht, weil die Last auf den menschlichen Reviewer verlagert wird.
Wann sollten Sie auf autonome KI-Agenten verzichten?
Verzichten Sie auf autonome Agenten in geschäftskritischer Infrastruktur, sicherheitsrelevanten Systemen oder monolithischen Repositories, in denen die Kosten einer einzigen ungeprüften Nebenwirkung die Vorteile schnellerer Codegenerierung übersteigen. In diesen Fällen ist eine von Menschen geführte Überprüfung nicht verhandelbar, und „Black-Box“-Tools bringen inakzeptable Risikoprofile mit sich.
Nächster Schritt
Nutzen Sie dies, um zu prüfen, wo KI-Agenten Leitplanken brauchen. Sprechen Sie mit DataTip.