

Stručně: AI agenti si důvěru nezískají, pokud týmy nedokážou předvídat jejich rozsah, uvažování ani vedlejší efekty. Jejich sklon upřednostňovat rychlost před striktním dodržováním instrukcí může vést k nevysvětleným změnám, rozšiřování rozsahu (scope creep) a značnému dluhu v podobě revizí. Bez transparentního uvažování, sdíleného kontextu a pevných hranic prostředí musí lidé provádět rozsáhlé forenzní audity, což z agentů dělá riziko pro kritické, regulované, bezpečnostně citlivé nebo těsně provázané systémy.
- Důvěra závisí více na konzistentním a spolehlivém chování než na hrubých schopnostech agenta.
- Uvažování typu „černá skříňka“ nutí vývojáře obhajovat rozhodnutí, která sami neudělali, a zakrývá nevyslovené předpoklady.
- Scope creep zvyšuje náročnost auditu, protože agenti upravují nesouvisející soubory, služby nebo globální konfigurace.
- Chybějící sdílené uvažování zvyšuje zátěž při údržbě a řešení incidentů, protože revidující vidí výsledky bez dostatečného kontextu.
- AI agenti potřebují přísné mantinely, vysvětlitelnost a lidský dohled, zejména v regulovaných nebo těsně provázaných prostředích.
Problém není jen v tom, že AI agenti dělají chyby. Jde o to, že týmy nedokážou vždy předvídat, kde agent zasáhne, co změní a kolik dluhu v podobě revizí vytvoří.
Tu chvíli frustrace zná každý z nás: spustíte AI nástroj, aby automatizoval rutinní úkol, a najdete diff, který mění soubory, na které jste nikdy nesáhli, git commit pushnutý bez povolení nebo instrukci, která nikdy neměla vzniknout. Nejde jen o drobné chyby; představují zásadní designovou vadu v tom, jak dnes s autonomními systémy pracujeme. Zatímco se odvětví upíná k benchmarkům LLM a hrubým schopnostem, ukazuje se, že skutečným úzkým hrdlem pro zkušené praktiky není inteligence – je to předvídatelnost. Mezera v předvídatelnosti je vzdálenost mezi tím, co od agenta očekáváme, a skutečným, často chaotickým rozsahem jeho výstupu.
U CTO a vedoucích provozu nadšení z vývoje poháněného AI rychle tlumí provozní realita údržby. Pokud nedokážete předvídat, jak se nástroj zachová, nemůžete se na něj spolehnout u kritické infrastruktury. Vidíme rostoucí mezeru v předvídatelnosti, kdy rychlost výstupů AI předbíhá naši schopnost je ověřit, a vzniká tak nová forma technického dluhu, kterou je těžší auditovat než tradiční legacy kód. Realita je taková, že tyto nástroje prostě neumějí sdělit, kdy se mýlí, pokud je na to výslovně neupozorníte. S výskytem těchto problémů musíte počítat všude, kde svému stacku plně nedůvěřujete.
Předvídatelnost a spolehlivost jsou základem důvěry v nástroje
Důvěra v náš inženýrský stack nevzniká z toho, že je nástroj „chytrý“; vzniká z toho, že je konzistentní. Předvídatelnost a spolehlivost jsou základem důvěry v nástroje a z dlouhodobého hlediska převažují nad hrubými schopnostmi. V produkčním prostředí je průměrný nástroj, který se chová pokaždé stejně, nesrovnatelně cennější než brilantní agent, který si občas vyhalucinuje změnu, jež něco rozbije. Nástroje používáme ke snížení kognitivní zátěže, ale když agentovi chybí spolehlivost, dělá pravý opak – nutí nás udržovat se ve stavu neustálé ostražitosti.
Když nový nástroj integrujeme do CI/CD pipeline nebo lokálního vývojového prostředí, v podstatě s ním uzavíráme smlouvu. Očekáváme, že vstup A povede k výstupu B. AI agenti však vstup A často berou jako vágní návrh a vrátí výstup B, C a pro jistotu ještě upravenou verzi D. Právě tato nekonzistence brání širokému nasazení na úrovni infrastruktury. Dokud agent nedokáže zaručit, že bude respektovat hranice svého prostředí, zůstává vysoce rizikovým aktivem.
Kdy nepoužívat: Nenasazujte vysoce autonomní agenty v prostředích s přísnou regulací nebo v bezpečnostně kritických částech, kde musí mít každý řádek kódu jasný, člověkem ověřitelný původ. Cena chyby „černé skříňky“ zde výrazně převyšuje jakékoli zrychlení. To platí zejména ve finančních službách nebo zdravotnických systémech, kde jsou auditní stopy nezbytností.
Uvažování agentů jako „černá skříňka“
Jedním z hlavních viníků nedostatku důvěry je transparentnost. Většina AI agentů funguje jako černé skříňky; dodají „co“ (změnu kódu), ale jen zřídka „proč“ (uvažování). Uvažování agentů v podobě „černé skříňky“ nutí vývojáře obhajovat rozhodnutí, která ve skutečnosti neudělali. Jako zkušení praktici se často ocitáme v nepříjemné pozici, kdy jsme tváří pull requestu, kterému plně nerozumíme. Pokud agent refaktoruje službu a vy nesledujete každý jednotlivý krok jeho uvažování, v podstatě v reálném čase přebíráte legacy codebase.
Bez náhledu do výchozích předpokladů nemůžeme agenta usměrnit, když začne sjíždět z kurzu. Transparentnost nám umožňuje odhalit chybný předpoklad včas a „srovnat kormidlo“ dřív, než se z diffu stane noční můra. Když nám naše nástroje neřeknou, co se děje pod kapotou, ztrácíme schopnost pochopit, co udržujeme a proč to udržujeme určitým způsobem. Už nejsme jen revidující; jsme forenzní vyšetřovatelé, kteří se zpětně snaží poskládat logiku agenta, což přispívá ke krizi znalostního dluhu.
Představte si situaci, kdy se agent rozhodne nahradit knihovnu, protože vnímá výkonnostní úzké hrdlo. Pokud agent toto konkrétní zdůvodnění nezveřejní, můžete změnu schválit a až později zjistit, že nové knihovně chybí kritická bezpečnostní funkce, na kterou váš tým spoléhá. Bez transparentnosti nese následky nevyslovených předpokladů stroje člověk.
AI agenti často trpí rozšiřováním rozsahu (scope creep)
AI agenti jsou stavění tak, aby byli nápomocní, ale často jsou nápomocní až příliš. AI agenti často trpí rozšiřováním rozsahu a optimalizují rychlost na úkor striktního dodržování instrukcí. To vede k chronickým problémům, kdy agent sahá na soubory mimo zamýšlený adresář nebo mění globální konfigurace, protože si „myslel“, že pomáhá. Pro vedoucí, kteří dohlížejí na rozsáhlé repozitáře, je to významný zdroj provozního tření.
Agent není zlovolný; jen mu chybí profesní zdrženlivost, která přichází s lety rozbíjení věcí v produkci. Vidí „čistší“ způsob, jak napsat pomocnou funkci, a změní ji, aniž by tušil, že právě rozbil tři další mikroslužby, které na této konkrétní implementaci závisely. Takové chování dělá code review exponenciálně náročnějším. Místo auditu cíleného diffu musíme prohledat celý projekt kvůli vedlejším efektům.
Mentální úsilí potřebné k ověření práce agenta roste s jeho rychlostí. Pokud agent dodává desetkrát rychleji než člověk, ale vyžaduje pětkrát větší úsilí při auditu, čistý přínos k produktivitě je zanedbatelný – a riziko otráveného prostředí roste. Jako maintainer nakonec kontrolujete celý diff místo té jediné věci, kterou jste očekávali. To je „nechtěná daň“ vývoje poháněného AI: čím víc agent udělá, tím víc musíte pochybovat.
Kdy nepoužívat: Nepoužívejte agenty typu „auto-fix“ v monolitických repozitářích nebo těsně provázaných systémech, kde změna v jednom modulu může spustit kaskádu selhání v nesouvisejících službách. Riziko nezamýšlených vedlejších efektů je příliš vysoké v systémech, kde je kód závazkem.
Chybějící sdílené uvažování zvyšuje mentální zátěž
Když pracujete s lidským kolegou, máte sdílený kontext vybudovaný prostřednictvím dokumentace, přímých zpráv a ústních konzultací. Rozumíte jeho stylu psaní kódu, typickým chybám i důvodům, proč volí jeden vzor místo jiného. U AI agentů máme v podstatě jen kód a okno chatu. Chybějící sdílené uvažování mezi člověkem a agentem zvyšuje mentální zátěž při code review a údržbě. Revidujeme práci bez kontextu interní fáze „brainstormingu“ agenta.
Do hlavy agenta se podívat nemůžete, což znamená, že práci revidujete bez potřebného kontextu. Protože za výstup nakonec odpovídáme my, potřebujeme víc než jen konečný výsledek. Při spolupráci s člověkem se můžete zeptat „proč jsi použil tuhle knihovnu?“ a dostanete nuancovanou odpověď. Od agenta dostanete diff a možná obecné vysvětlení, které zní jako z učebnice. Vzniká tak situace, kdy se prodíráme úzkým hrdlem produktivity AI, protože rychlému výstupu chybí „proč“, které najdete ve smysluplných lozích.
Tento nedostatek kontextu je obzvlášť bolestivý během nouzových pohotovostních služeb. Pokud změna vygenerovaná AI způsobí produkční incident ve 03:00, inženýr na pohotovosti nemá žádnou dokumentaci ani „sdílené uvažování“, o které by se mohl opřít. Dívá se na kód vygenerovaný systémem, který se už přesunul k dalšímu promptu, a člověku zůstává znalostní dluh.
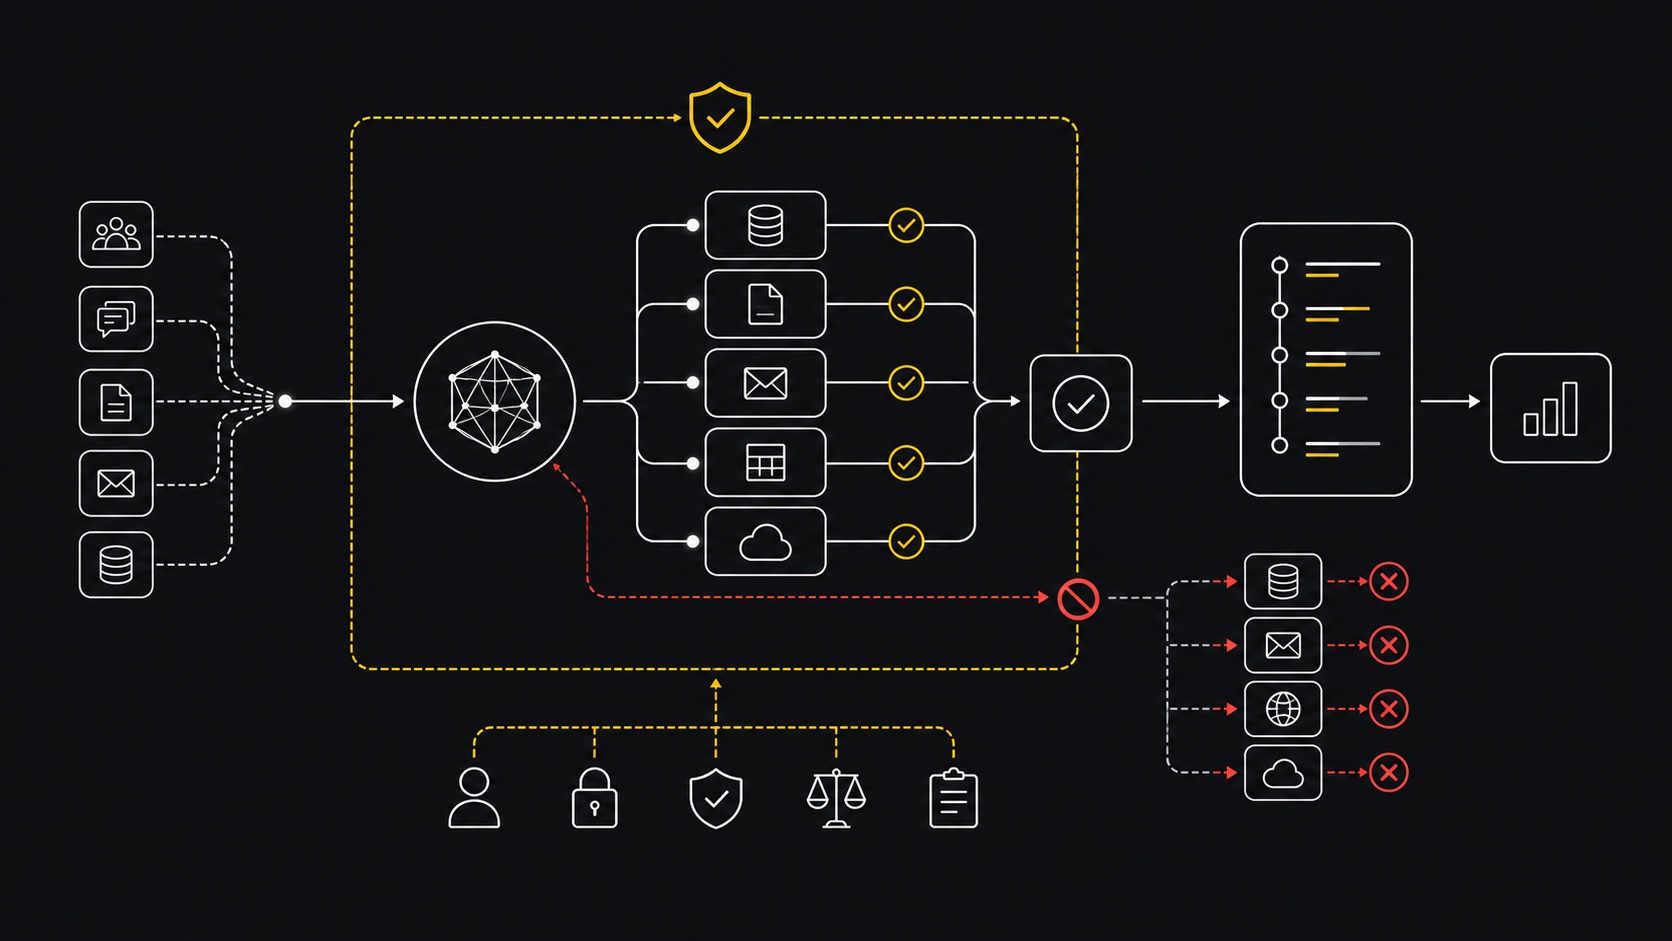
Jak překlenout mezeru v návrhu AI nástrojů
Transparentnost, scope creep i chybějící sdílené uvažování jsou symptomy téhož problému: AI nástroje jsou dnes navrženy jako samostatní přispěvatelé, nikoli jako spolupracující partneři. Abychom mezeru v předvídatelnosti překlenuli, potřebujeme nástroje, které upřednostňují stanovování hranic a vysvětlitelnost před hrubou rychlostí. Musíme opustit model „černé skříňky“ a přejít k přístupu „skleněné skříňky“, kde je uvažování stejně důležité jako samotný commit. Jde o zásadní krok každé strategie digitální transformace.
Pro CTO to znamená nastavit jasné mantinely. S AI agenty musíme zacházet jako s velmi rychlými juniory, kteří vyžadují přísný dohled, jasné hranice a neustálé kladení otázek. Cílem není přestat AI používat, ale používat ji se zdravou skepsí, kterou profesionální inženýrství vyžaduje. Musíme zajistit, aby se náš přístup díval za hranice samotného nástroje a řešil skrytou mezeru v návrhu. Nacházíme se v přechodné fázi, kdy jsou nástroje dost silné na to, aby byly nebezpečné, ale ještě ne dost disciplinované na to, abychom jim mohli věřit bez lidské záchranné sítě.
Klíčové poznatky
- Důvěra stojí na předvídatelnosti: Bez ohledu na to, jak schopný agent je, dlouhodobě se neprosadí, pokud jeho výstupy nejsou spolehlivé a konzistentní.
- Problém transparentnosti: Bez náhledu do kroků uvažování vývojáři nakonec obhajují technická rozhodnutí, která ve skutečnosti nikdy neudělali.
- Scope creep je auditní riziko: Agenti optimalizují rychlost, často sahají na soubory mimo své instrukce a zvyšují mentální zátěž při code review.
- Kontext je klíčový: Chybějící sdílené uvažování (přímé zprávy, dokumentace) dělá z AI agentů horší spolupracovníky než z lidí, navzdory jejich rychlosti.
Co je hlavní příčinou mezery v předvídatelnosti?
Mezera v předvídatelnosti vzniká tím, že AI agenti upřednostňují rychlost dokončení před přesností a dodržováním instrukcí. To vede k uvažování typu „černá skříňka“ a nezamýšleným změnám, které nutí vývojáře auditovat celý systém místo toho, aby mohli důvěřovat konkrétním výstupům. Mezeru dále prohlubuje nedostatečná transparentnost toho, jak agent ke konkrétnímu řešení dospěje.
Proč scope creep u AI ztěžuje code review?
Scope creep nastává, když agent mění soubory nebo konfigurace mimo zadaný úkol. Maintaineři pak musí provádět úplný forenzní audit celé codebase, aby našli vedlejší efekty, místo aby se soustředili na logiku požadované změny. Tím se rychlostní výhody AI fakticky ruší, protože zátěž se přesouvá na lidského revidujícího.
Kdy byste se měli autonomním AI agentům vyhnout?
Autonomním agentům se vyhněte v kritické infrastruktuře, bezpečnostně citlivých systémech nebo monolitických repozitářích, kde cena jediného neověřeného vedlejšího efektu převyšuje přínosy rychlejšího generování kódu. V těchto případech je ověřování vedené lidmi nezbytností a použití nástrojů typu „černá skříňka“ přináší nepřijatelnou míru rizika.
Další krok
Využijte tento článek k auditu toho, kde AI agenti potřebují mantinely. Promluvte si s DataTip.