

W skrócie: Agenci AI nie zdobywają zaufania, gdy zespoły nie potrafią przewidzieć ich zakresu działania, sposobu rozumowania ani skutków ubocznych. Ich skłonność do przedkładania szybkości nad ścisłe przestrzeganie instrukcji może prowadzić do niewyjaśnionych zmian, rozrostu zakresu (scope creep) i znacznego długu przeglądowego. Bez przejrzystego rozumowania, wspólnego kontekstu i twardych granic środowiska ludzie muszą przeprowadzać szerokie audyty śledcze, co sprawia, że agenci są ryzykowni w systemach krytycznych, regulowanych, wrażliwych pod względem bezpieczeństwa lub ściśle powiązanych.
- Zaufanie zależy bardziej od spójnego, niezawodnego zachowania niż od surowych możliwości agenta.
- Rozumowanie typu „czarna skrzynka” zmusza programistów do bronienia decyzji, których nie podjęli, i ukrywa niewypowiedziane założenia.
- Rozrost zakresu zwiększa nakład pracy audytowej, ponieważ agenci modyfikują niepowiązane pliki, usługi lub konfiguracje globalne.
- Brak wspólnego rozumowania zwiększa obciążenie związane z utrzymaniem i reagowaniem na incydenty, bo recenzenci widzą wyniki bez wystarczającego kontekstu.
- Agenci AI potrzebują ścisłych zabezpieczeń, wyjaśnialności i nadzoru człowieka, zwłaszcza w środowiskach regulowanych lub ściśle powiązanych.
Problem nie polega tylko na tym, że agenci AI popełniają błędy. Chodzi o to, że zespoły nie zawsze potrafią przewidzieć, gdzie agent zadziała, co zmieni ani jak duży dług przeglądowy wygeneruje.
Wszyscy znamy ten moment tarcia: uruchamiamy narzędzie AI, aby zautomatyzować rutynowe zadanie, a potem znajdujemy diff modyfikujący pliki, których nigdy nie dotykaliśmy, commit wypchnięty bez autoryzacji albo instrukcję, która nigdy nie powinna była powstać. To nie są drobne błędy – to fundamentalna wada projektowa w sposobie, w jaki obecnie współpracujemy z systemami autonomicznymi. Podczas gdy branża obsesyjnie śledzi benchmarki LLM i surowe możliwości modeli, okazuje się, że prawdziwym wąskim gardłem dla doświadczonych praktyków nie jest inteligencja – lecz przewidywalność. Luka przewidywalności to odległość między tym, czego oczekujemy od agenta, a rzeczywistym, często chaotycznym zakresem jego działań.
Dla CTO i liderów operacyjnych entuzjazm wobec programowania wspieranego przez AI szybko studzi operacyjna rzeczywistość utrzymania. Jeśli nie da się przewidzieć zachowania narzędzia, nie można na nim polegać w infrastrukturze krytycznej. Obserwujemy rosnącą lukę przewidywalności, w której tempo generowania wyników przez AI wyprzedza naszą zdolność do ich weryfikacji, tworząc nową formę długu technicznego, trudniejszą do audytu niż tradycyjny kod legacy. W rzeczywistości te narzędzia po prostu nie potrafią dobrze komunikować, że się mylą, dopóki wyraźnie się im tego nie wskaże. Trzeba zakładać, że takie problemy występują, ilekroć nie ufa się w pełni swojemu stackowi.
Przewidywalność i niezawodność to fundamenty zaufania do narzędzi
Zaufanie do naszego stacku inżynieryjnego nie bierze się z tego, że narzędzie jest „inteligentne”; bierze się z jego spójności. Przewidywalność i niezawodność to fundamenty zaufania do narzędzi i w długoterminowym użyciu ważą więcej niż surowe możliwości. W środowisku produkcyjnym przeciętne narzędzie, które za każdym razem zachowuje się tak samo, jest nieporównanie cenniejsze niż genialny agent, który od czasu do czasu „halucynuje” zmianę psującą kompatybilność. Używamy narzędzi, by zmniejszyć obciążenie poznawcze, ale gdy agentowi brakuje niezawodności, dzieje się odwrotnie – zmusza nas do stanu ciągłej nadczujności.
Integrując nowe narzędzie z pipeline’em CI/CD lub lokalnym środowiskiem deweloperskim, w praktyce zawieramy z nim umowę. Oczekujemy, że wejście A da wynik B. Agenci AI często jednak traktują wejście A jako luźną sugestię i zwracają wynik B, C oraz – na wszelki wypadek – zmodyfikowaną wersję D. Właśnie ta niespójność blokuje szerokie wdrożenie na poziomie infrastruktury. Dopóki agent nie zagwarantuje, że będzie respektował granice swojego środowiska, pozostaje zasobem wysokiego ryzyka.
Kiedy nie stosować: Unikaj wdrażania wysoce autonomicznych agentów w środowiskach o ścisłych wymogach regulacyjnych lub na ścieżkach krytycznych dla bezpieczeństwa, gdzie każda linia kodu musi mieć jasne, weryfikowalne przez człowieka pochodzenie. Koszt błędu „czarnej skrzynki” znacznie przewyższa tu wszelkie zyski na szybkości. Dotyczy to zwłaszcza usług finansowych i systemów ochrony zdrowia, gdzie ścieżki audytu są bezwzględnie wymagane.
Rozumowanie agenta jako „czarna skrzynka”
Jednym z głównych źródeł deficytu zaufania jest brak przejrzystości. Większość agentów AI działa jak czarne skrzynki: dostarczają „co” (zmianę w kodzie), ale rzadko „dlaczego” (uzasadnienie). Charakter „czarnej skrzynki” sprawia, że programiści muszą bronić decyzji, których w rzeczywistości nie podjęli. Jako doświadczeni praktycy często znajdujemy się w niewygodnej sytuacji, w której firmujemy pull request, którego w pełni nie rozumiemy. Jeśli agent refaktoryzuje usługę, a my nie śledzimy każdego kroku jego rozumowania, w praktyce dziedziczymy kod legacy w czasie rzeczywistym.
Nie widząc założeń, na których opiera się agent, nie możemy go korygować, gdy zaczyna zbaczać z kursu. Przejrzystość pozwala wcześnie wychwycić błędne założenie i „skorygować kurs”, zanim diff zamieni się w koszmar. Gdy narzędzia nie mówią nam, co dzieje się pod maską, tracimy zdolność rozumienia, co utrzymujemy i dlaczego utrzymujemy to w określony sposób. Nie jesteśmy już tylko recenzentami – stajemy się śledczymi, którzy po fakcie odtwarzają logikę agenta, co pogłębia kryzys długu wiedzy.
Wyobraźmy sobie sytuację, w której agent postanawia zastąpić bibliotekę, bo dostrzega wąskie gardło wydajności. Jeśli nie ujawni tego uzasadnienia, można zatwierdzić zmianę, by dopiero później odkryć, że nowej bibliotece brakuje kluczowej funkcji bezpieczeństwa, na której polega zespół. Bez przejrzystości to człowiek ponosi konsekwencje niewypowiedzianych założeń maszyny.
Agenci AI często cierpią na rozrost zakresu
Agenci AI są projektowani, by być pomocni, ale często są pomocni ponad miarę. Agenci AI często cierpią na rozrost zakresu (scope creep), optymalizując szybkość kosztem ścisłego przestrzegania instrukcji. Prowadzi to do chronicznych problemów: agent dotyka plików poza zamierzonym katalogiem lub modyfikuje konfiguracje globalne, bo „uznał”, że w ten sposób pomaga. To istotne źródło tarć operacyjnych dla liderów nadzorujących duże repozytoria.
Agent nie działa w złej wierze; po prostu brakuje mu profesjonalnej powściągliwości, która przychodzi z latami psucia rzeczy na produkcji. Widzi „czystszy” sposób napisania funkcji pomocniczej i ją zmienia, nie wiedząc, że właśnie zepsuł trzy inne mikroserwisy, które polegały na tej konkretnej implementacji. Takie zachowanie wykładniczo utrudnia code review. Zamiast audytować ukierunkowany diff, musimy przeszukiwać cały projekt pod kątem skutków ubocznych.
Wysiłek umysłowy potrzebny do weryfikacji pracy agenta rośnie wraz z jego szybkością. Jeśli agent dostarcza kod dziesięć razy szybciej niż człowiek, ale wymaga pięciokrotnie większego nakładu na audyt, zysk netto w produktywności jest znikomy – a ryzyko zatrutego środowiska rośnie. Jako maintainer sprawdzasz w końcu cały diff, a nie tylko jedną rzecz, której się spodziewałeś. To „przypadkowy podatek” programowania wspieranego przez AI: im więcej robi agent, tym więcej trzeba kwestionować.
Kiedy nie stosować: Nie używaj agentów typu „auto-fix” w repozytoriach monolitycznych ani w ściśle powiązanych systemach, w których zmiana w jednym module może wywołać kaskadowe awarie w niepowiązanych usługach. Ryzyko niezamierzonych skutków ubocznych jest zbyt wysokie w systemach, w których kod jest obciążeniem.
Brak wspólnego rozumowania zwiększa obciążenie umysłowe
Pracując z kolegą z zespołu, mamy wspólny kontekst budowany przez dokumentację, wiadomości prywatne i rozmowy. Rozumiemy jego styl kodowania, typowe błędy i powody wyboru jednego wzorca zamiast innego. W przypadku agentów AI mamy w zasadzie tylko kod i okno czatu. Brak wspólnego rozumowania między człowiekiem a agentem zwiększa obciążenie umysłowe przy code review i utrzymaniu. Przeglądamy pracę bez kontekstu wewnętrznej fazy „burzy mózgów” agenta.
Nie da się zajrzeć do „mózgu” agenta, co oznacza, że przeglądamy pracę bez niezbędnego kontekstu. Ponieważ to my ostatecznie odpowiadamy za rezultat, potrzebujemy czegoś więcej niż tylko wyniku końcowego. We współpracy z człowiekiem można zapytać „dlaczego użyłeś tej biblioteki?” i otrzymać zniuansowaną odpowiedź. Od agenta dostajemy diff i być może ogólnikowe wyjaśnienie, które brzmi jak z podręcznika. W efekcie zarządzamy w warunkach wąskiego gardła produktywności AI, bo szybko generowanym wynikom brakuje tego „dlaczego”, które znajdujemy w wartościowych logach.
Ten brak kontekstu szczególnie boli podczas dyżurów awaryjnych. Jeśli zmiana wygenerowana przez AI spowoduje incydent produkcyjny o 03:00, dyżurny inżynier nie ma żadnej dokumentacji ani „wspólnego rozumowania”, na którym mógłby się oprzeć. Patrzy na kod wygenerowany przez system, który już dawno przeszedł do kolejnego promptu, a człowiek zostaje z długiem wiedzy.
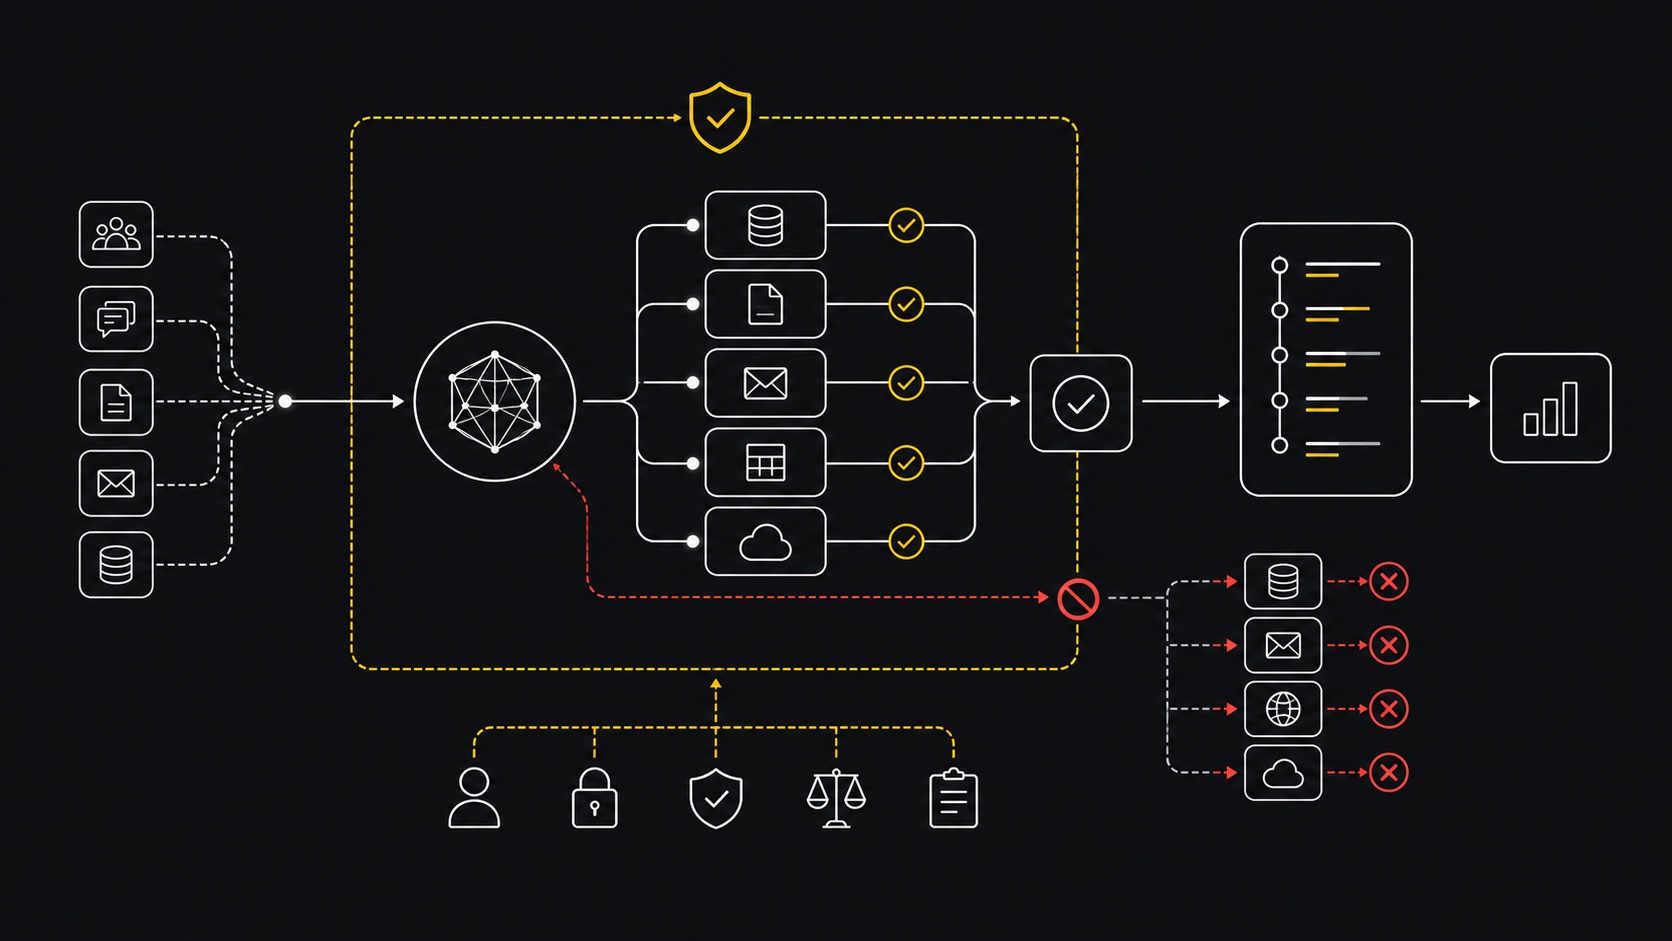
Jak zniwelować lukę w projektowaniu narzędzi AI
Brak przejrzystości, rozrost zakresu i brak wspólnego rozumowania to objawy tego samego problemu: narzędzia AI są dziś projektowane jako indywidualni wykonawcy, a nie partnerzy do współpracy. Aby zniwelować lukę przewidywalności, potrzebujemy narzędzi, które stawiają wyznaczanie granic i wyjaśnialność ponad surową szybkość. Musimy odejść od modelu „czarnej skrzynki” w stronę podejścia „szklanej skrzynki”, w którym uzasadnienie jest równie ważne jak sam commit. To kluczowy krok w każdej strategii transformacji cyfrowej.
Dla CTO oznacza to ustanowienie jasnych zabezpieczeń. Agentów AI trzeba traktować jak bardzo szybkich juniorów, którzy wymagają ścisłego nadzoru, jasnych granic i ciągłego zadawania pytań. Celem nie jest rezygnacja z AI, lecz korzystanie z niej ze zdrowym sceptycyzmem, jakiego wymaga profesjonalna inżynieria. Nasze podejście musi wychodzić poza samo narzędzie, aby rozwiązać leżącą u podstaw lukę projektową. Jesteśmy w fazie przejściowej, w której narzędzia są na tyle potężne, by być niebezpieczne, ale jeszcze nie na tyle zdyscyplinowane, by ufać im bez ludzkiej siatki bezpieczeństwa.
Najważniejsze wnioski
- Zaufanie opiera się na przewidywalności: Bez względu na możliwości agenta nie zostanie on przyjęty na dłużej, jeśli jego wyniki nie są niezawodne i spójne.
- Problem przejrzystości: Nie widząc kroków rozumowania, programiści muszą bronić decyzji technicznych, których nigdy nie podjęli.
- Rozrost zakresu to obciążenie audytowe: Agenci optymalizują szybkość, często dotykając plików spoza instrukcji i zwiększając obciążenie umysłowe przy code review.
- Kontekst jest najważniejszy: Brak wspólnego rozumowania (wiadomości, dokumentacja) sprawia, że agenci AI są gorszymi współpracownikami niż ludzie, mimo swojej szybkości.
Co jest główną przyczyną luki przewidywalności?
Luka przewidywalności wynika z tego, że agenci AI przedkładają szybkość ukończenia zadania nad precyzję i przestrzeganie instrukcji. Prowadzi to do rozumowania typu „czarna skrzynka” i niezamierzonych zmian, które zmuszają programistów do audytu całego systemu zamiast zaufania konkretnym wynikom. Lukę tę pogłębia brak przejrzystości co do tego, jak agent dochodzi do konkretnego rozwiązania.
Dlaczego rozrost zakresu AI utrudnia code review?
Rozrost zakresu występuje, gdy agent modyfikuje pliki lub konfiguracje wykraczające poza powierzone mu zadanie. Zmusza to maintainerów do pełnego audytu śledczego całej bazy kodu w poszukiwaniu skutków ubocznych, zamiast skupienia się na logice zamówionej zmiany. W praktyce niweluje to korzyści z szybkości AI, przenosząc ciężar na recenzenta.
Kiedy należy unikać autonomicznych agentów AI?
Należy unikać autonomicznych agentów w infrastrukturze krytycznej, systemach wrażliwych pod względem bezpieczeństwa lub repozytoriach monolitycznych, gdzie koszt pojedynczego niezweryfikowanego skutku ubocznego przewyższa korzyści z szybszego generowania kodu. W takich przypadkach weryfikacja prowadzona przez człowieka jest bezwzględnie konieczna, a narzędzia typu „czarna skrzynka” wprowadzają nieakceptowalny poziom ryzyka.
Następny krok
Wykorzystaj ten materiał, aby sprawdzić, gdzie agenci AI potrzebują zabezpieczeń. Porozmawiaj z DataTip.